MySQL实践-锁和高可用
锁和高可用
order by是怎么工作的?
创建向表t插入数据的存储过程,删除存储过程drop procedure city_date;。
delimiter ;;
create procedure city_data()
begin
  declare i int;
  set i=1;
  while(i<=6000) do
       if i <= 4000 then
         insert into t values(i, 'hangzhou', 'tony', 12, 'hangzhou2');
       else
         insert into t values(i, 'beijing', 'lili', 13, 'beijing3');
       end if;
       set i=i+1;
  end while;
end;;
delimiter ;
call city_data();
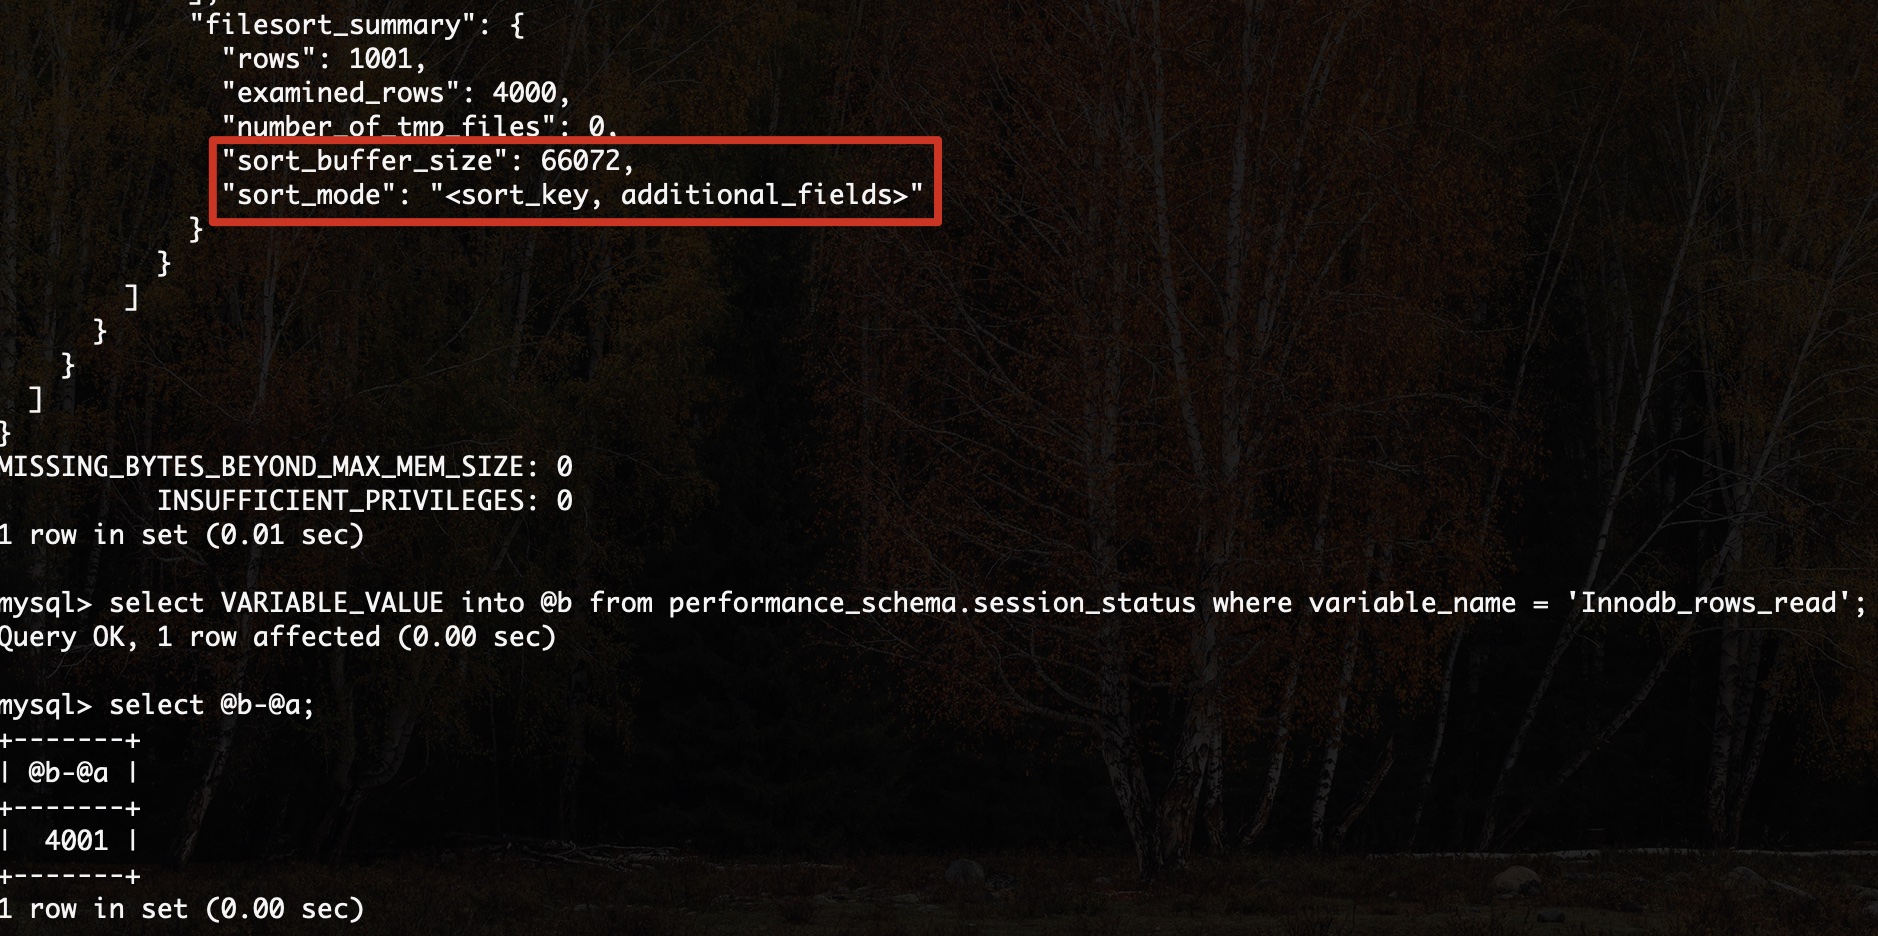
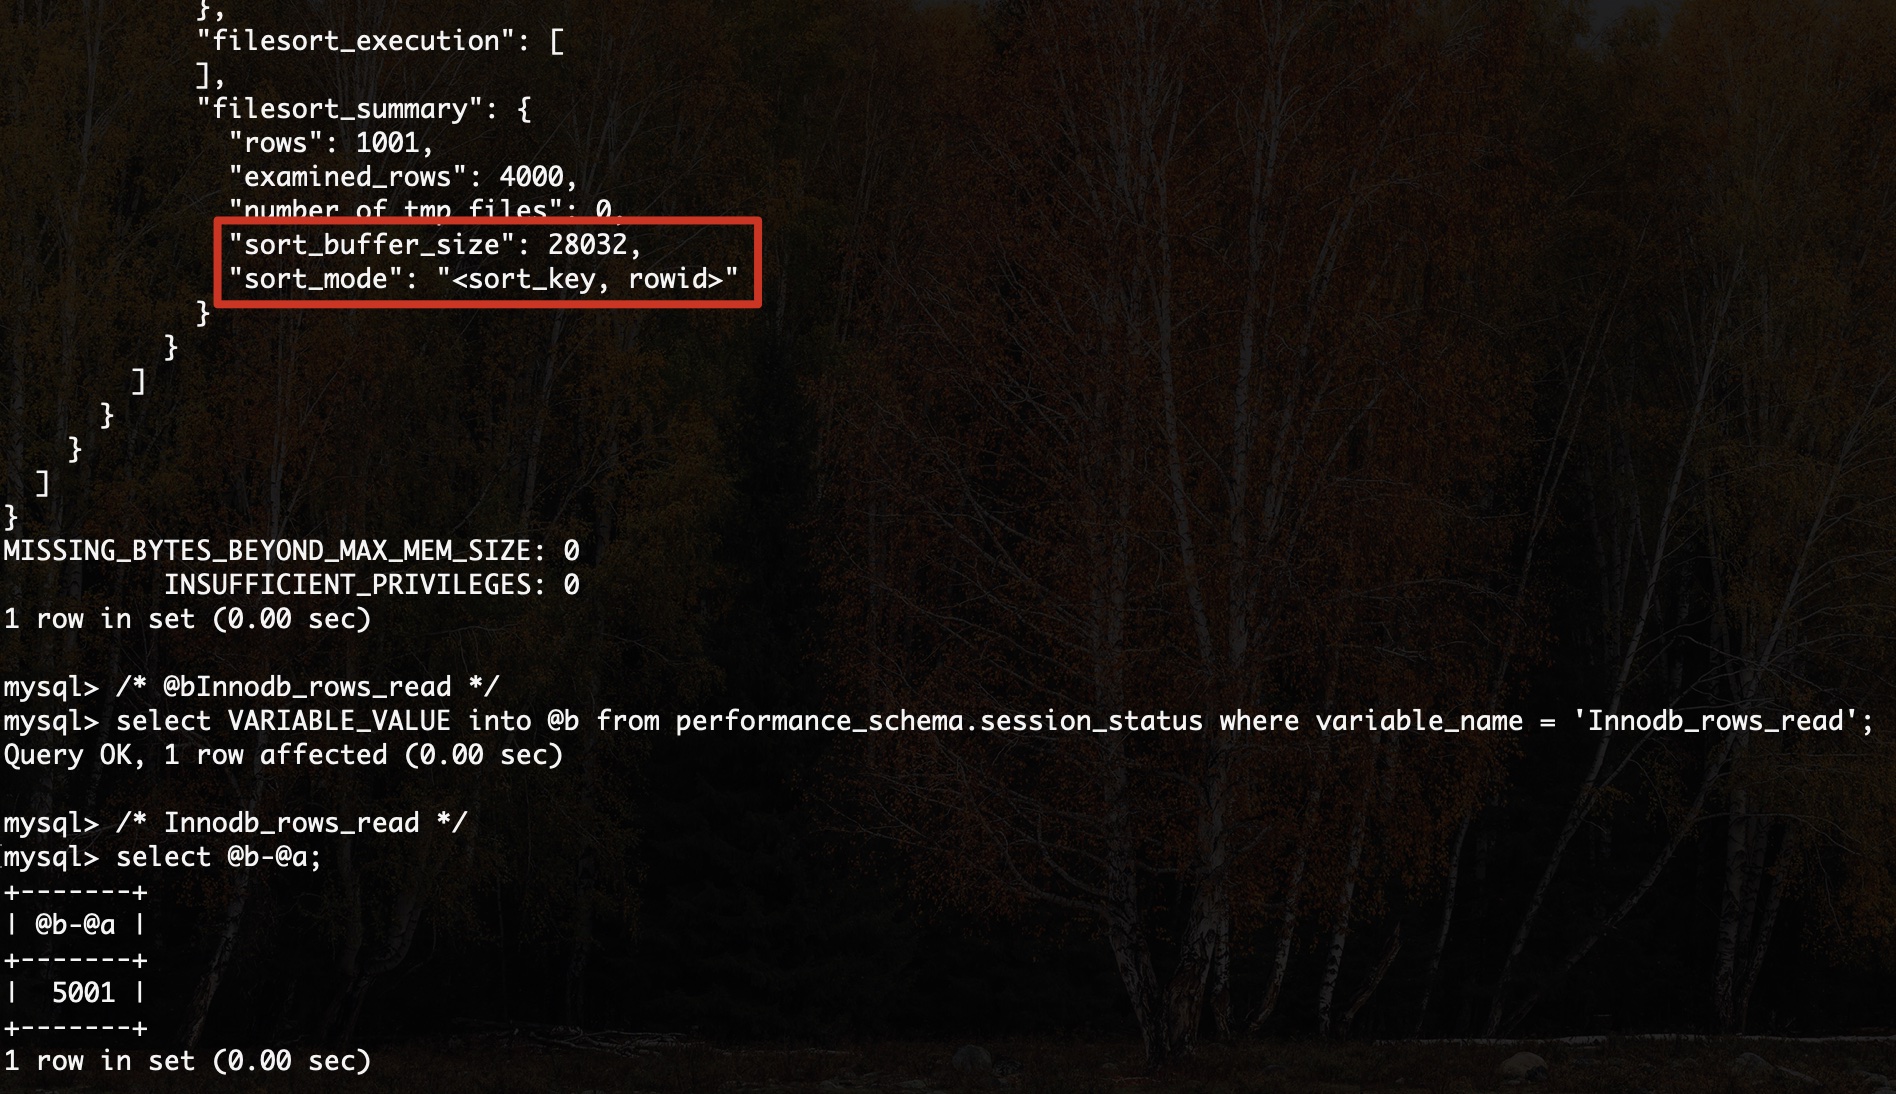
全字段排序,explain语句后会有Using filesort,sort_buffer_size就是MySQL为排序开辟的内存(sort_buffer)的大小。
select city,name,age from t where city='杭州' order by name limit 1000;

/* 打开optimizer_trace,只对本线程有效 */
SET optimizer_trace='enabled=on';
/* @a保存Innodb_rows_read的初始值 */
select VARIABLE_VALUE into @a from  performance_schema.session_status where variable_name = 'Innodb_rows_read';
/* 执行语句 */
select city, name,age from t where city='hangzhou' order by name limit 1000;
/* 查看 OPTIMIZER_TRACE 输出 */
SELECT * FROM `information_schema`.`OPTIMIZER_TRACE`\G
/* @b保存Innodb_rows_read的当前值 */
select VARIABLE_VALUE into @b from performance_schema.session_status where variable_name = 'Innodb_rows_read';
/* 计算Innodb_rows_read差值 */
select @b-@a;
rowid排序和全部字段排序,查看trace后,当sort_buffer比较大时,sort_mode为additional_fields,比较小时,sort_mode为row_key。
谈几个索引不生效的场景
1、tradelog表中t_modified字段有索引,但使用month函数后,在sql查询时,索引会失效。原因是,对索引字段做函数操作,可能会破坏索引值的
有序性,因此优化器就决定放弃走树搜索功能。
select count(*) from tradelog where month(t_modified)=7;
2、第二种是隐式类型转换,在如下的sql中,在字符串与数值比较时,实际会使用cast函数将字符串转换为整数,由于加了函数,也会导致索引失效。
/* tradeid 的字段类型是 varchar(32),而输入的参数却是整型 */
select * from tradelog where tradeid = 110717;
/* 等价于如下的sql内容,从本质看,也是使用了CAST函数 */
mysql> select * from tradelog where CAST(tradid AS signed int) = 110717;
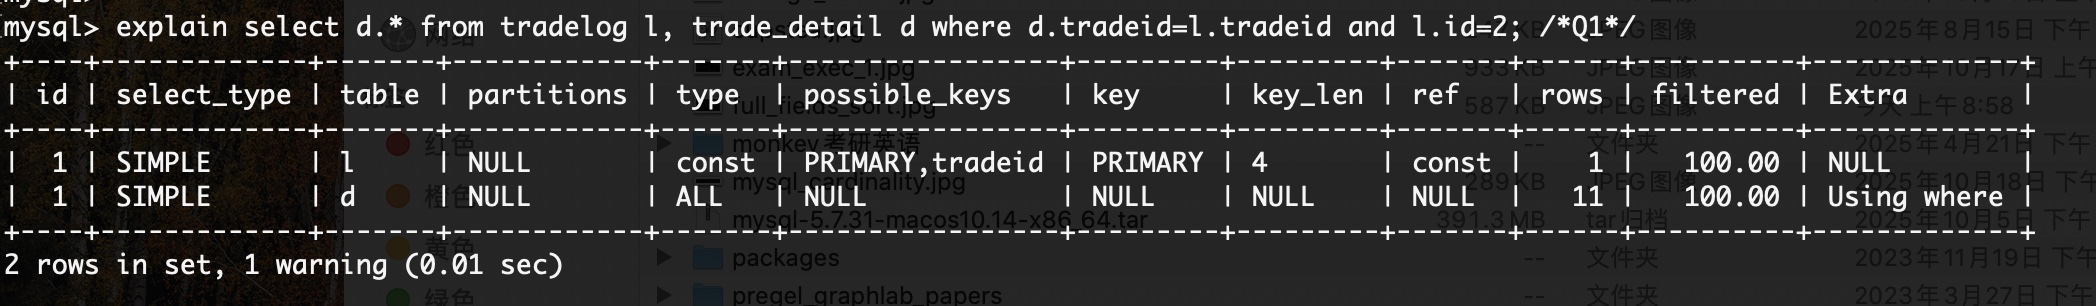
3、关联的字段字符集不统一,导致的索引失效,在如下表中tradelog表的字符集是utf8mb4,trade_detail表的字符集是utf8。
select d.* from tradelog l, trade_detail d where d.tradeid=l.tradeid and l.id=2; /*Q1*/
查看sql的执行计划,其中tradelog为utf8mb4,与detail表字符集不统一,导致在第二行中key列为NULL,导致走的全表扫描。明明detail表的tradeid有索引,但是使用不上。
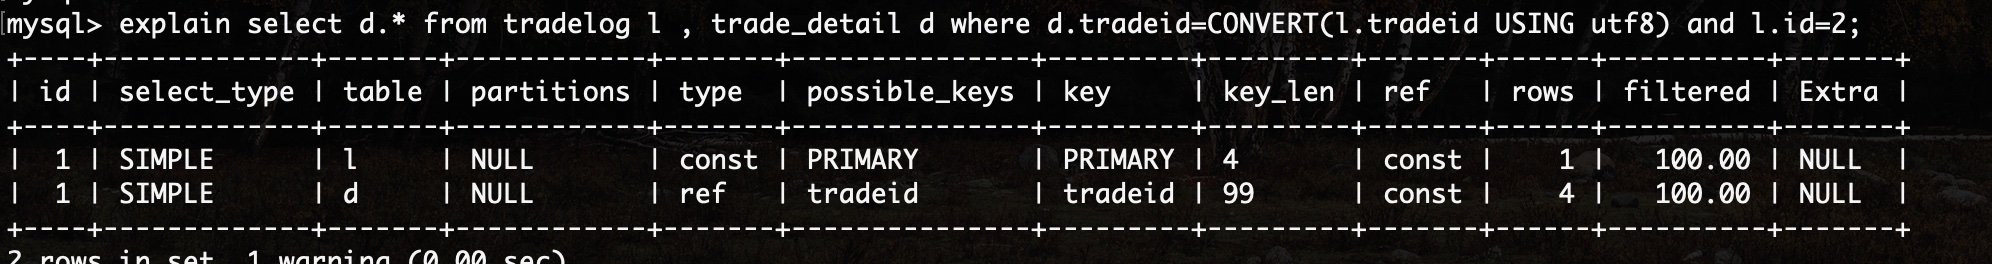
在统一tradeid的字符集为utf8后,在执行计划的第2行的key列,其值为traceid,使用上了索引。
执行单条sql语句但很慢的原因?
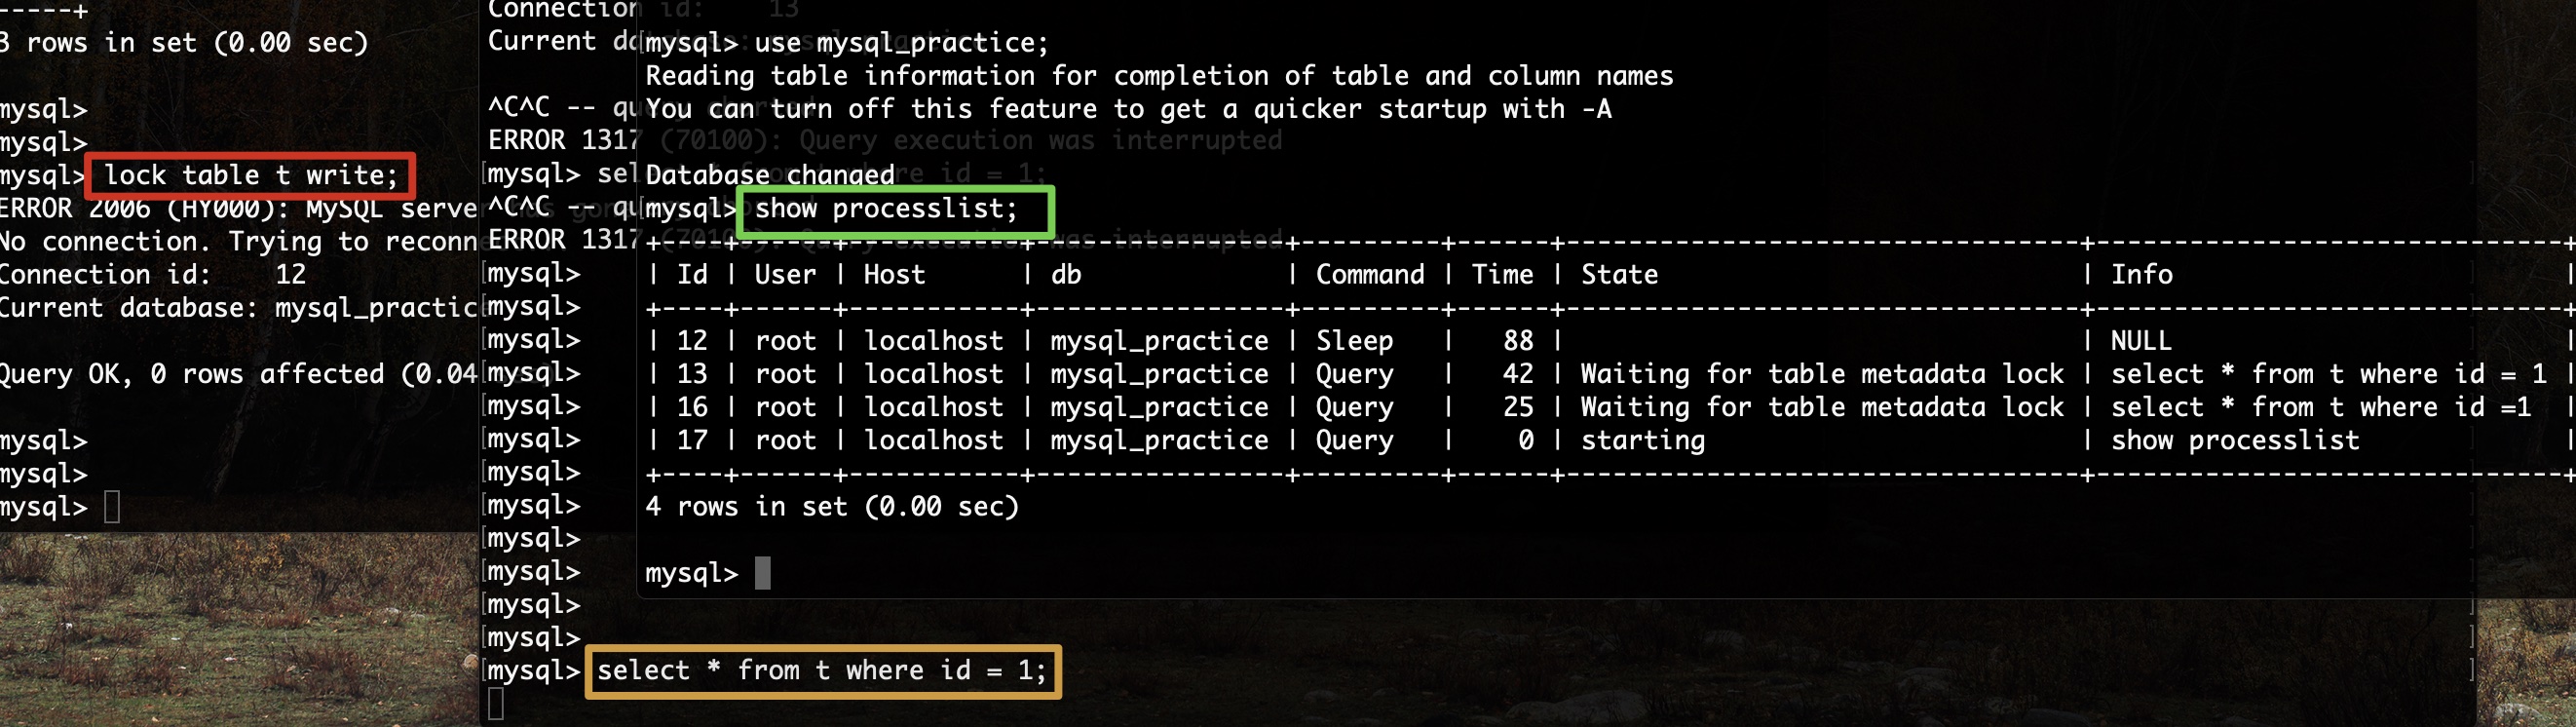
1、当session A持有表t的MDL写锁,而session B查询需要获取MDL读锁,所以,session B的查询进入等待状态。这类问题处理,就是找到谁持有
MDL写锁,然后把它kill掉。
/* 在`session A`中执行`unlock tables;`会释放表上的锁,解除死锁 */
lock table t write;
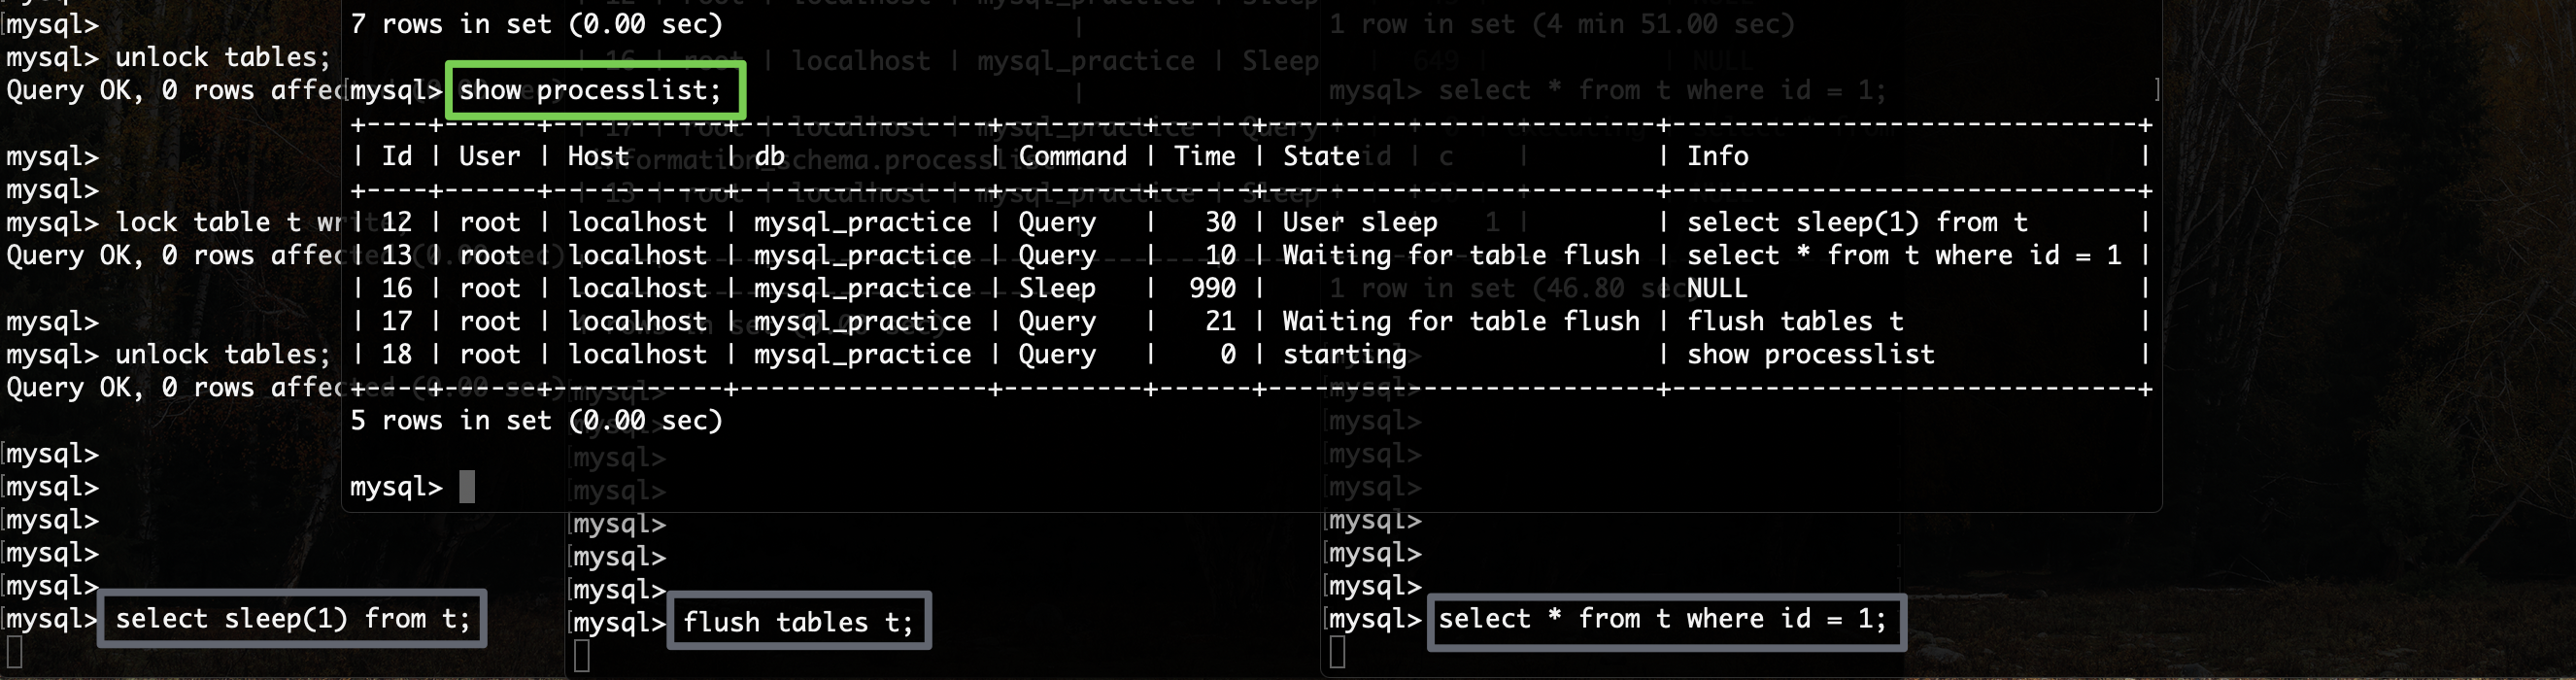
2、等待表flush,下图中的session C就处于阻塞的情况,等待flush tables完成操作。
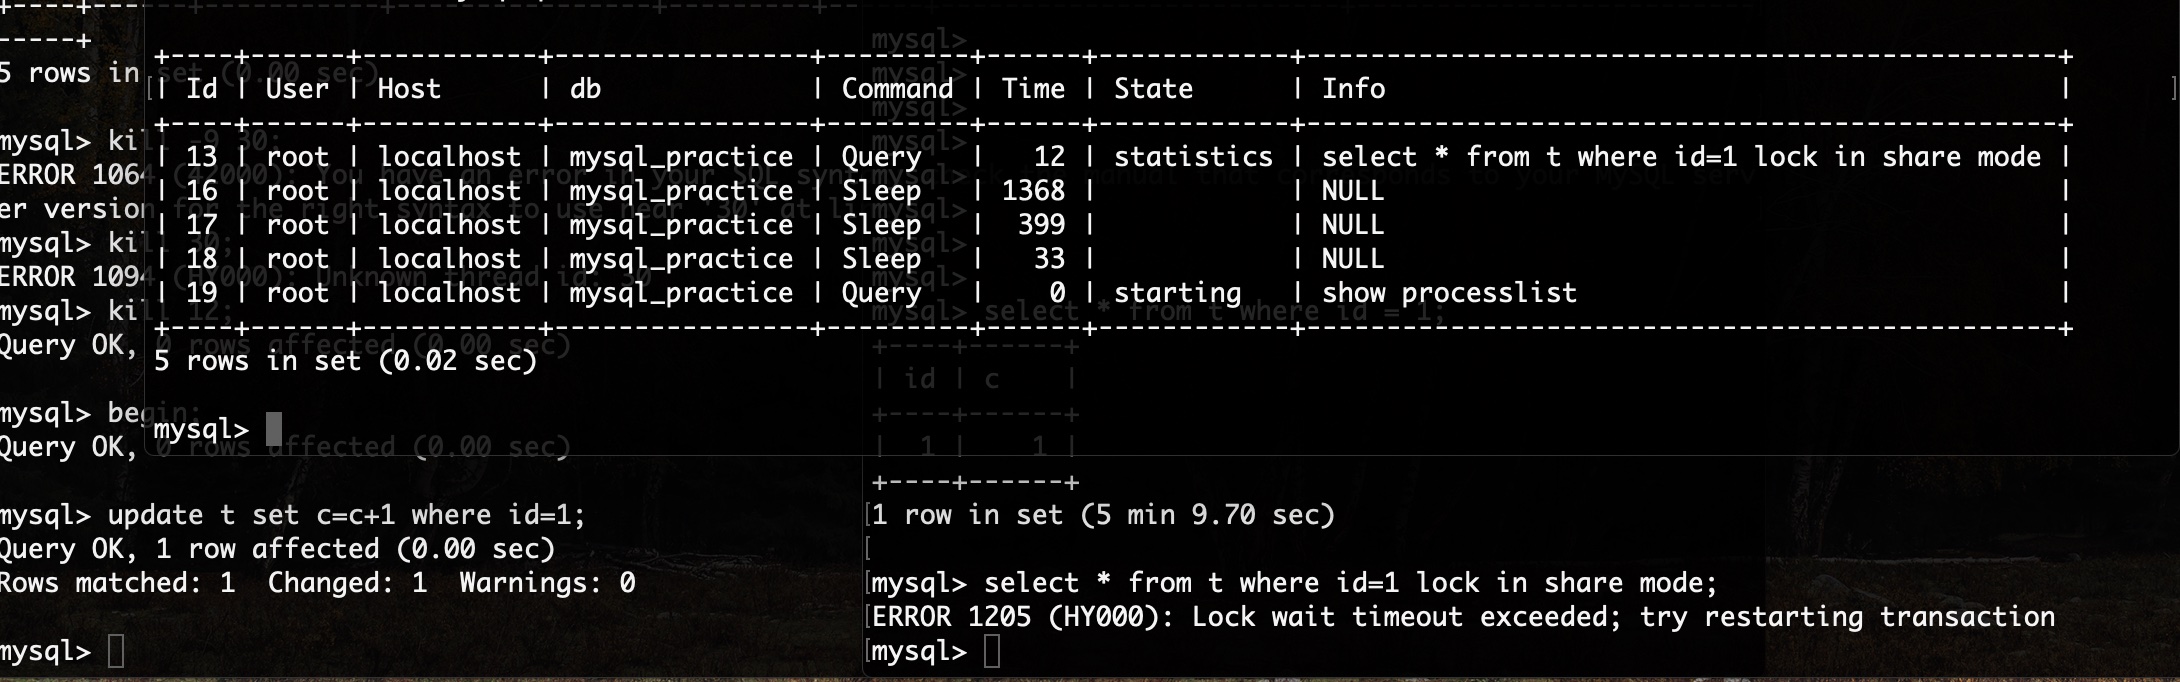
3、等行锁,session A启动事务,并且不进行提交,session B查询时使用lock in share mode方式,则就会被阻塞。
mysql中的幻读是怎么解决的?
session A用beigin;开启事务,然后用sql select * from t where d=5 for update;,此时session B和session C的语句都处于阻塞状态。
产生幻读的原因是,行锁只能锁住行,但是新插入记录这个动作,要更新的是记录之间的“间隙”。为了解决幻读问题,InnoDB 只好引入新的锁,也就是间隙锁 (Gap Lock)。
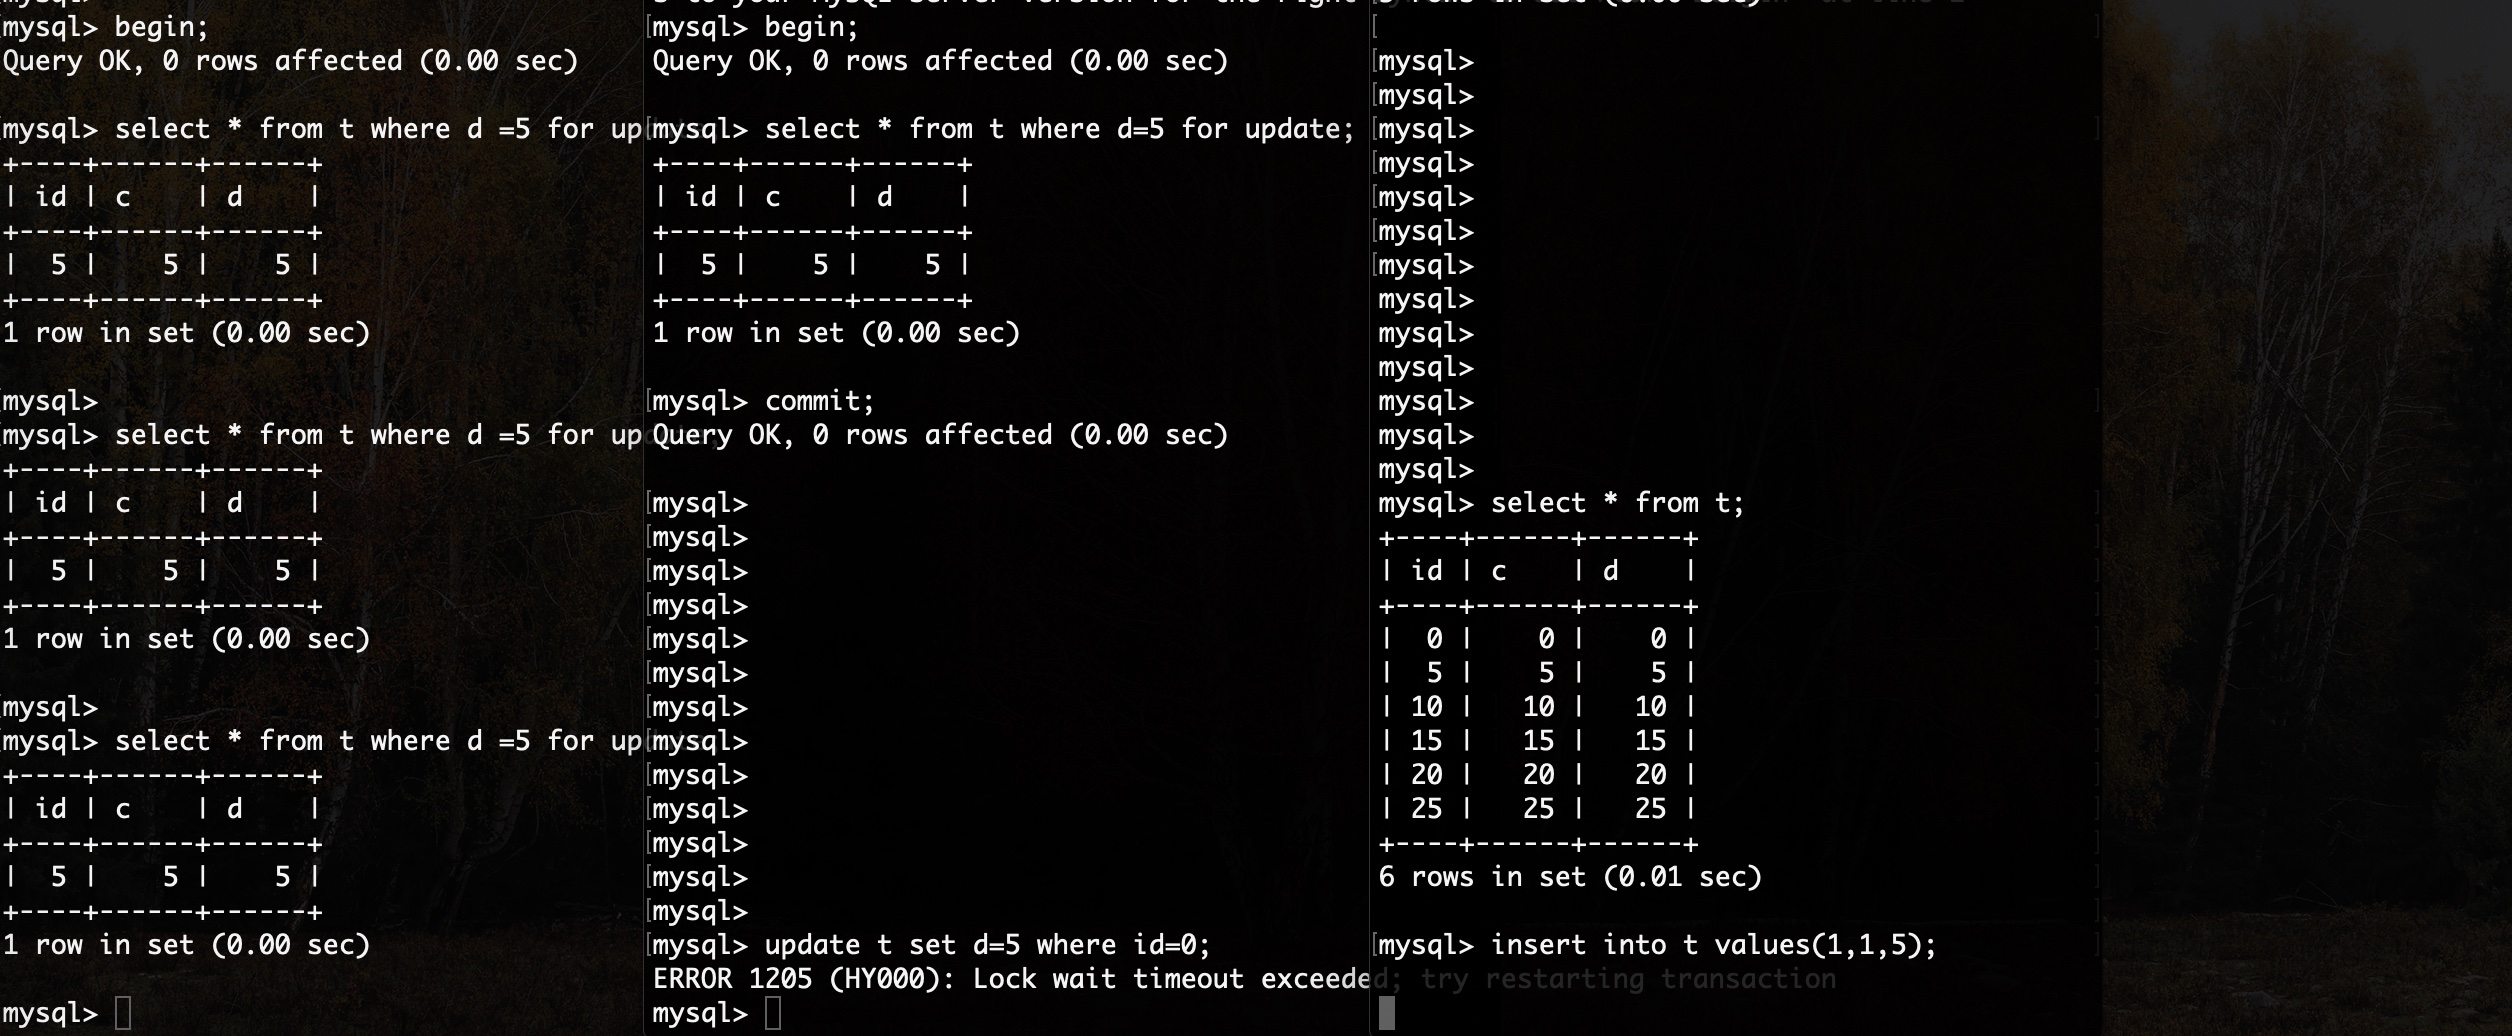
如下图所示,库中有6条记录,但生成了7个间隙锁,间隙锁会阻止在间隙中插入记录行。
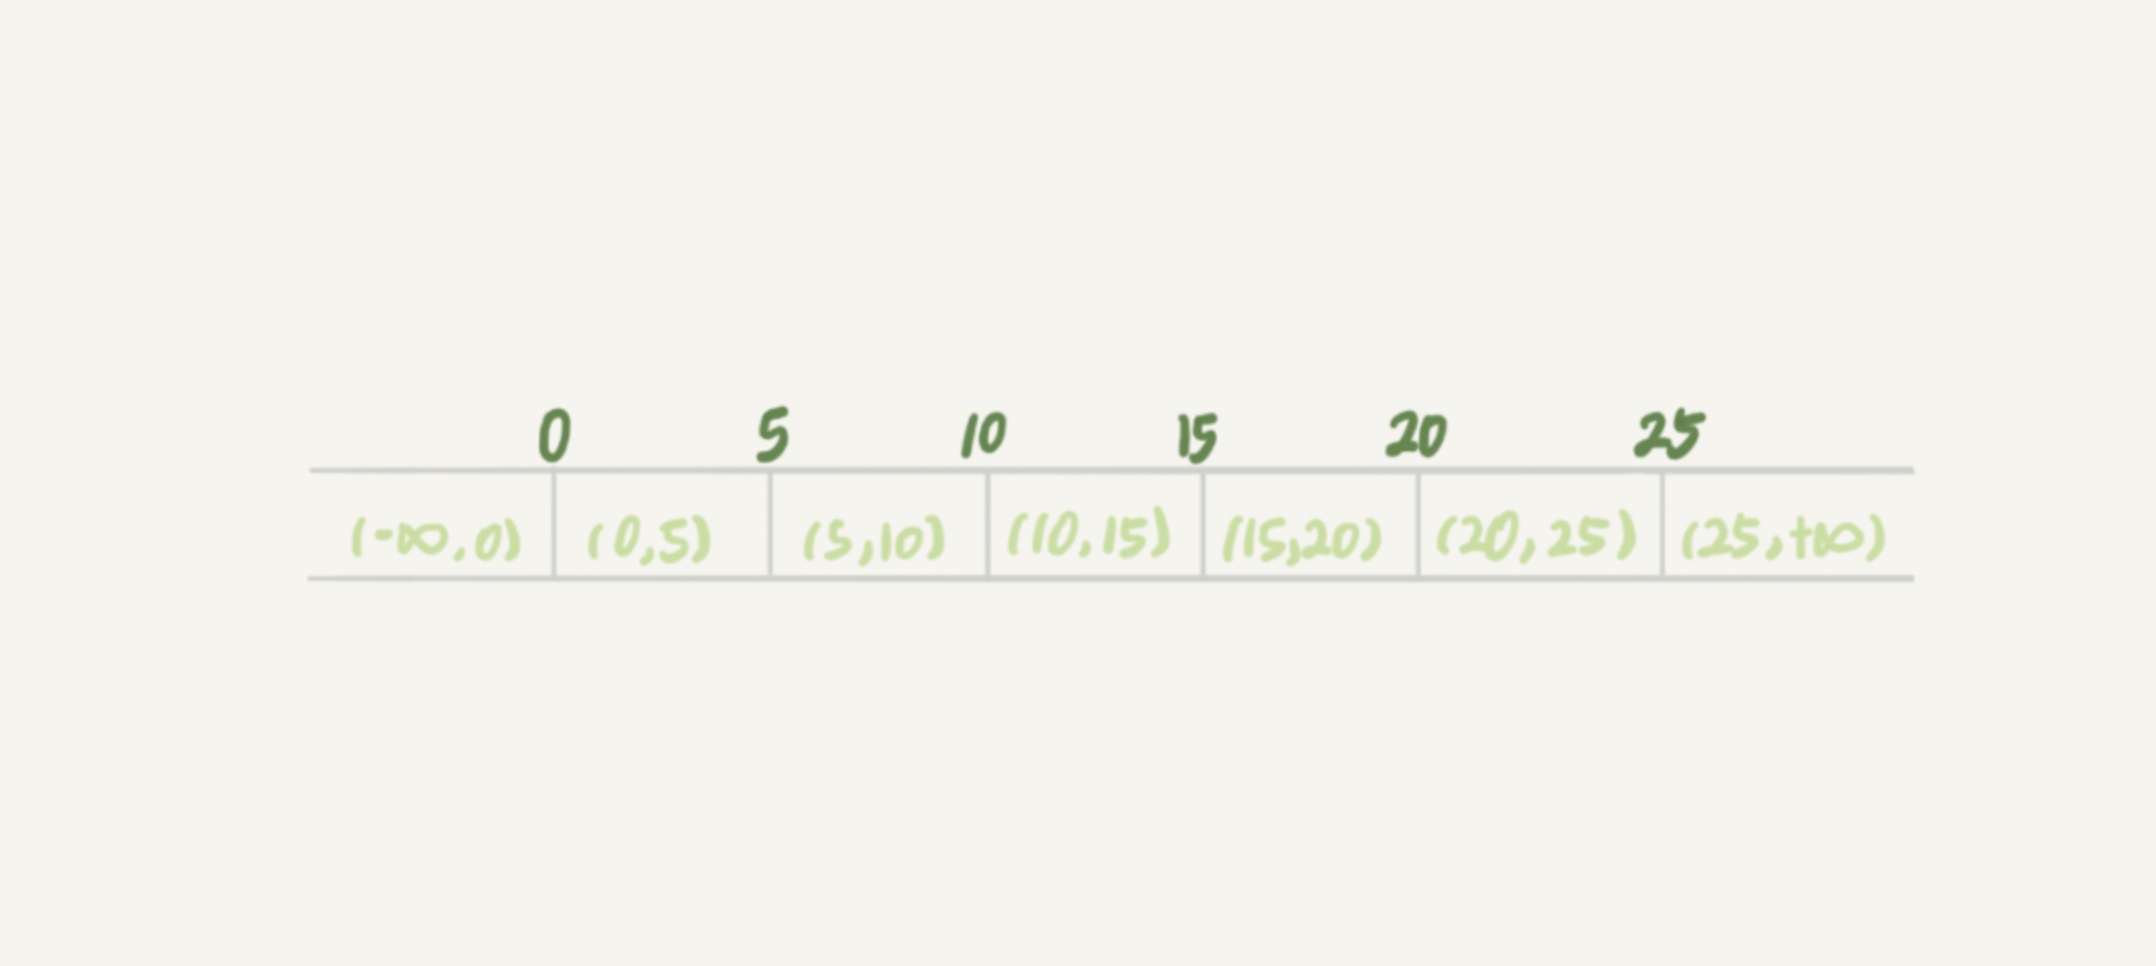
mysql中加锁的规则
mysql的加锁规则中,包含了两个原则、两个优化和一个bug:
- 原则
1,加锁的基本单位是next-key lock,其对应前开后闭区间。 - 原则
2,查找过程中访问的对象才会加锁。 - 优化
1,索引上的等值查询,给唯一索引加锁的时候,next-key lock退化为行锁。 - 优化
2,索引上的等值查询,向右遍历时且最后一个值不满足等值条件的时候,next-key lock退化为间隙锁。 - 一个
bug,唯一索引上的范围查询会访问到不满足条件的第一个值为止。
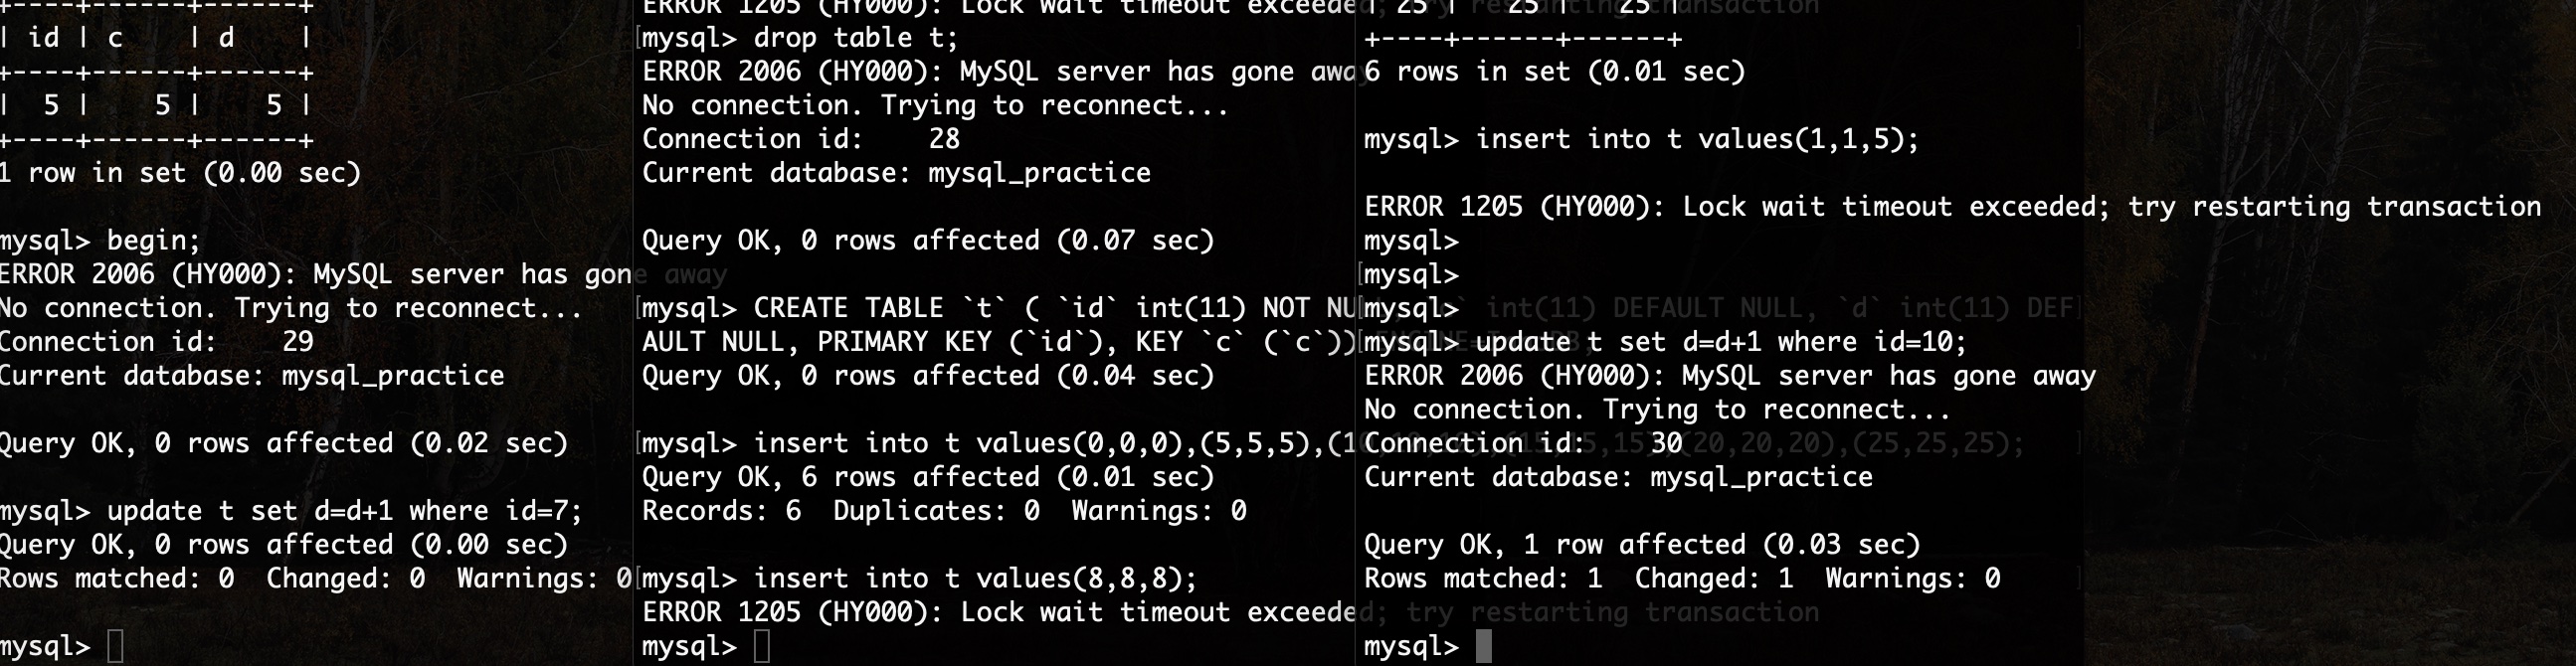
等值查询,在最左侧的Session A中,会加上(5,10)这个范围的间隙锁,因而Session B会阻塞,Session C可正常执行。
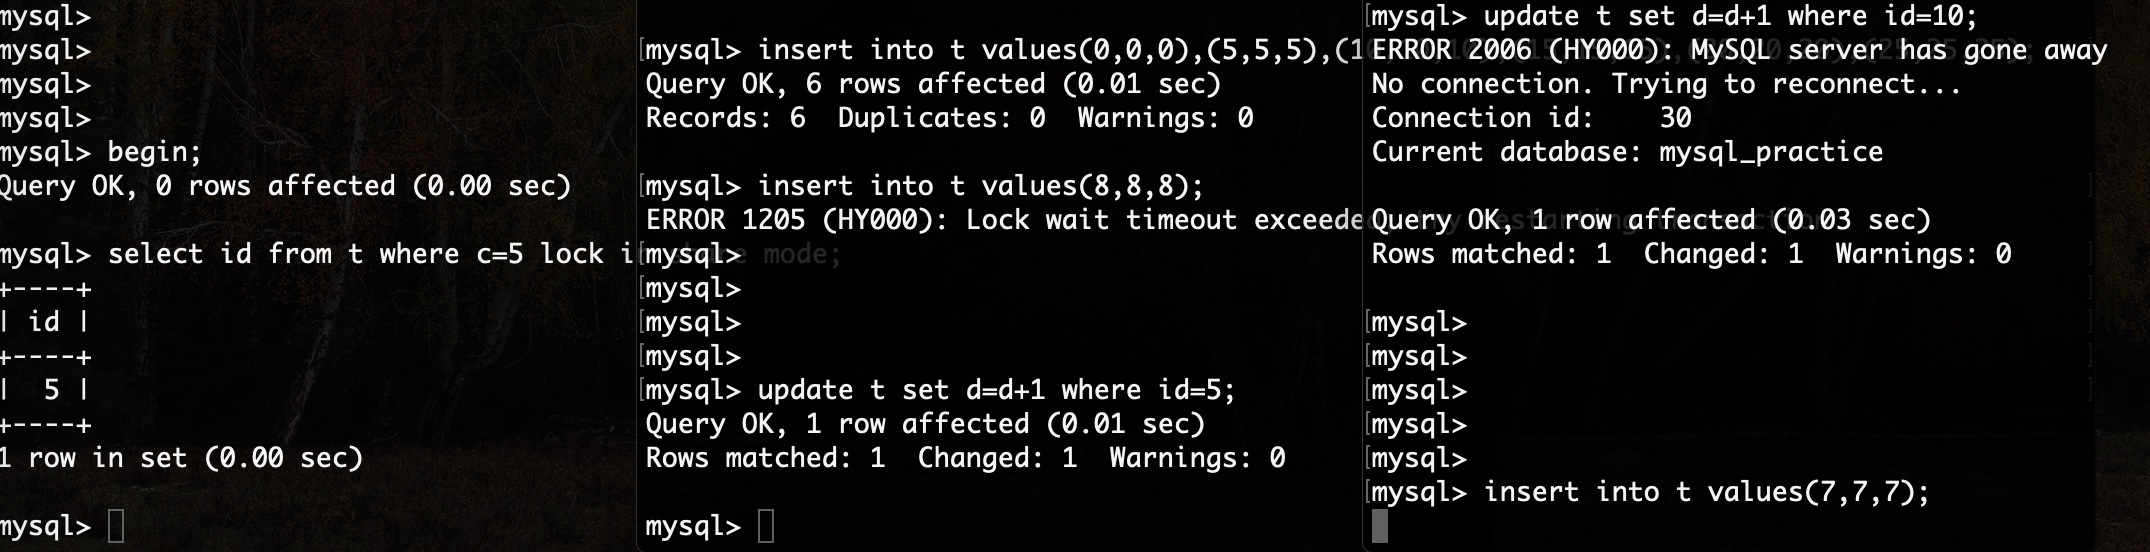
非唯一索引等值锁,Session A会在(0,5)和(5,10)上加间隙锁,此外,Session A的查询语句使用覆盖索引,并不需要访问主键,因而,主键索引上没有任何锁,Session B的语句可正常执行。
此外,limit场景,在删除数据的时候尽量加limit,不仅可以控制删除数据的条数,还可以减小锁的范围。
mysql高可用和主备延迟
主备延迟,有哪些可能的原因?
- 有些部署条件下,备库所在机器的性能要比主库所在的机器性能差。
- 备库的压力大,备库上执行一些运营后台需要的分析语句,耗费了大量的
CPU资源,影响了同步速度,造成主备延迟。 - 大事务,如果一个主库上的语句执行
10分钟,那这个事务很可能就会导致从库延迟10分钟,一次性地用delete语句删除太多数据。
备库和主库延迟可以用seconds_behind_master这个指标判断,其单位为s,需根据实际情况,看满足”可用性优先策略”还是”可靠性优先策略”。
mysql在5.6版本引入了GTID(Global Transaction Identifier,也称全局事务ID)来改善主备同步麻烦的问题。
GTID=source_id:transaction_id
实例A’的GTID集合记为set_a,实例B的GTID集合记为set_b,在实例B上执行start slave命令,取binlog的逻辑是这样的:
- 实例
B指定主库A’,基于主备协议建立连接。 - 实例
B把set_b发给主库A’。 - 实例
A’算出set_a与set_b的差集,也就是所有存在于set_a,但是不存在于set_b的GTID的集合,判断A’本地是否包含了这个差集需要的所有binlog事务。- a. 如果不包含,表示
A’已经把实例B需要的binlog给删掉了,直接返回错误; - b. 如果确认全部包含,
A’从自己的binlog文件里面,找出第一个不在set_b的事务,发给B;
- a. 如果不包含,表示
- 之后就从这个事务开始,往后读文件,按顺序取
binlog发给B去执行。