数据安全和表 join
数据被误删后,应怎么办?
我们不止要说误删数据的事后处理办法,更重要是要做到事前预防。我有以下两个建议:
- 把
sql_safe_updates参数设置为on。这样一来,如果我们忘记在delete或者update语句中写where条件,或者where条件里面没有包含索引字段的话,这条语句的执行就会报错。 - 代码上线前,必须经过
SQL审计。
mysql中的kill命令,一个是kill query + 线程id,表示终止这个线程中正在执行的语句;一个是kill connection + 线程id,表示断开这个线程的连接。
sql kill不掉的原因,其实是因为发送kill命令的客户端,并没有强行停止目标线程的执行,而只是设置了个状态,并唤醒对应的线程。而被kill的线程,需要执行到判断状态的”埋点”,才会开始进入终止逻辑阶段。并且,终止逻辑本身也是需要耗费时间的。
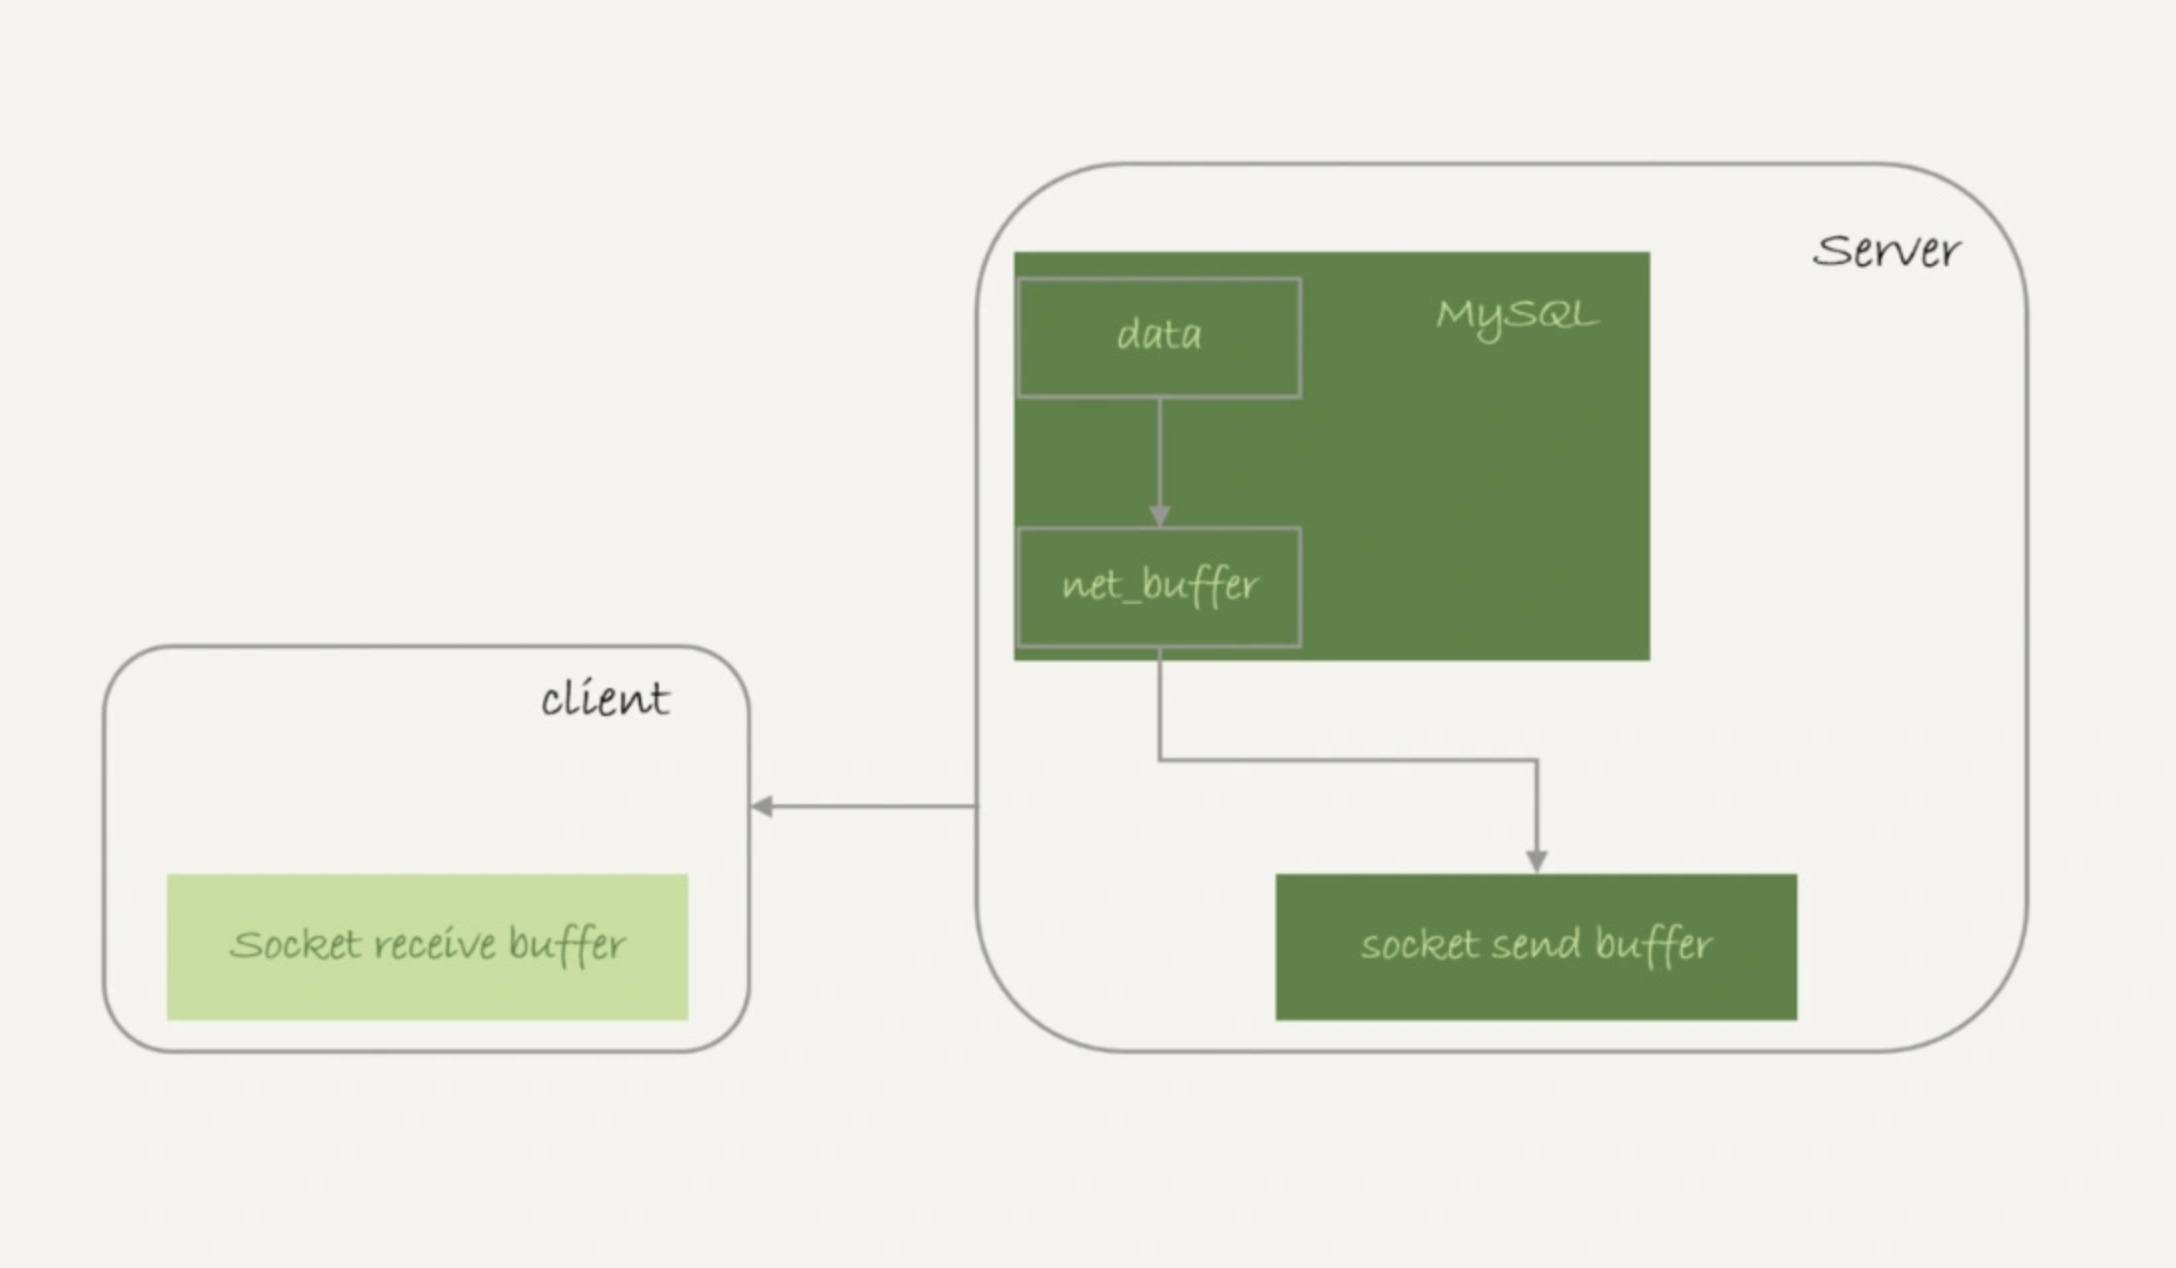
在mysql中,对一个200G的大表做全表扫描,会不会把内存用光? 如下图所示,mysql是边读边发的:
- 从
mysql读出的行会写到net_buffer中,此内存大小由net_buffer_length定义,默认16k; net_buffer写满后,会调用网络接口发出去,然后继续取下一行;socket send buffer本地网络栈写满后,会进入等待,直到网络栈重新可写,再继续发送;
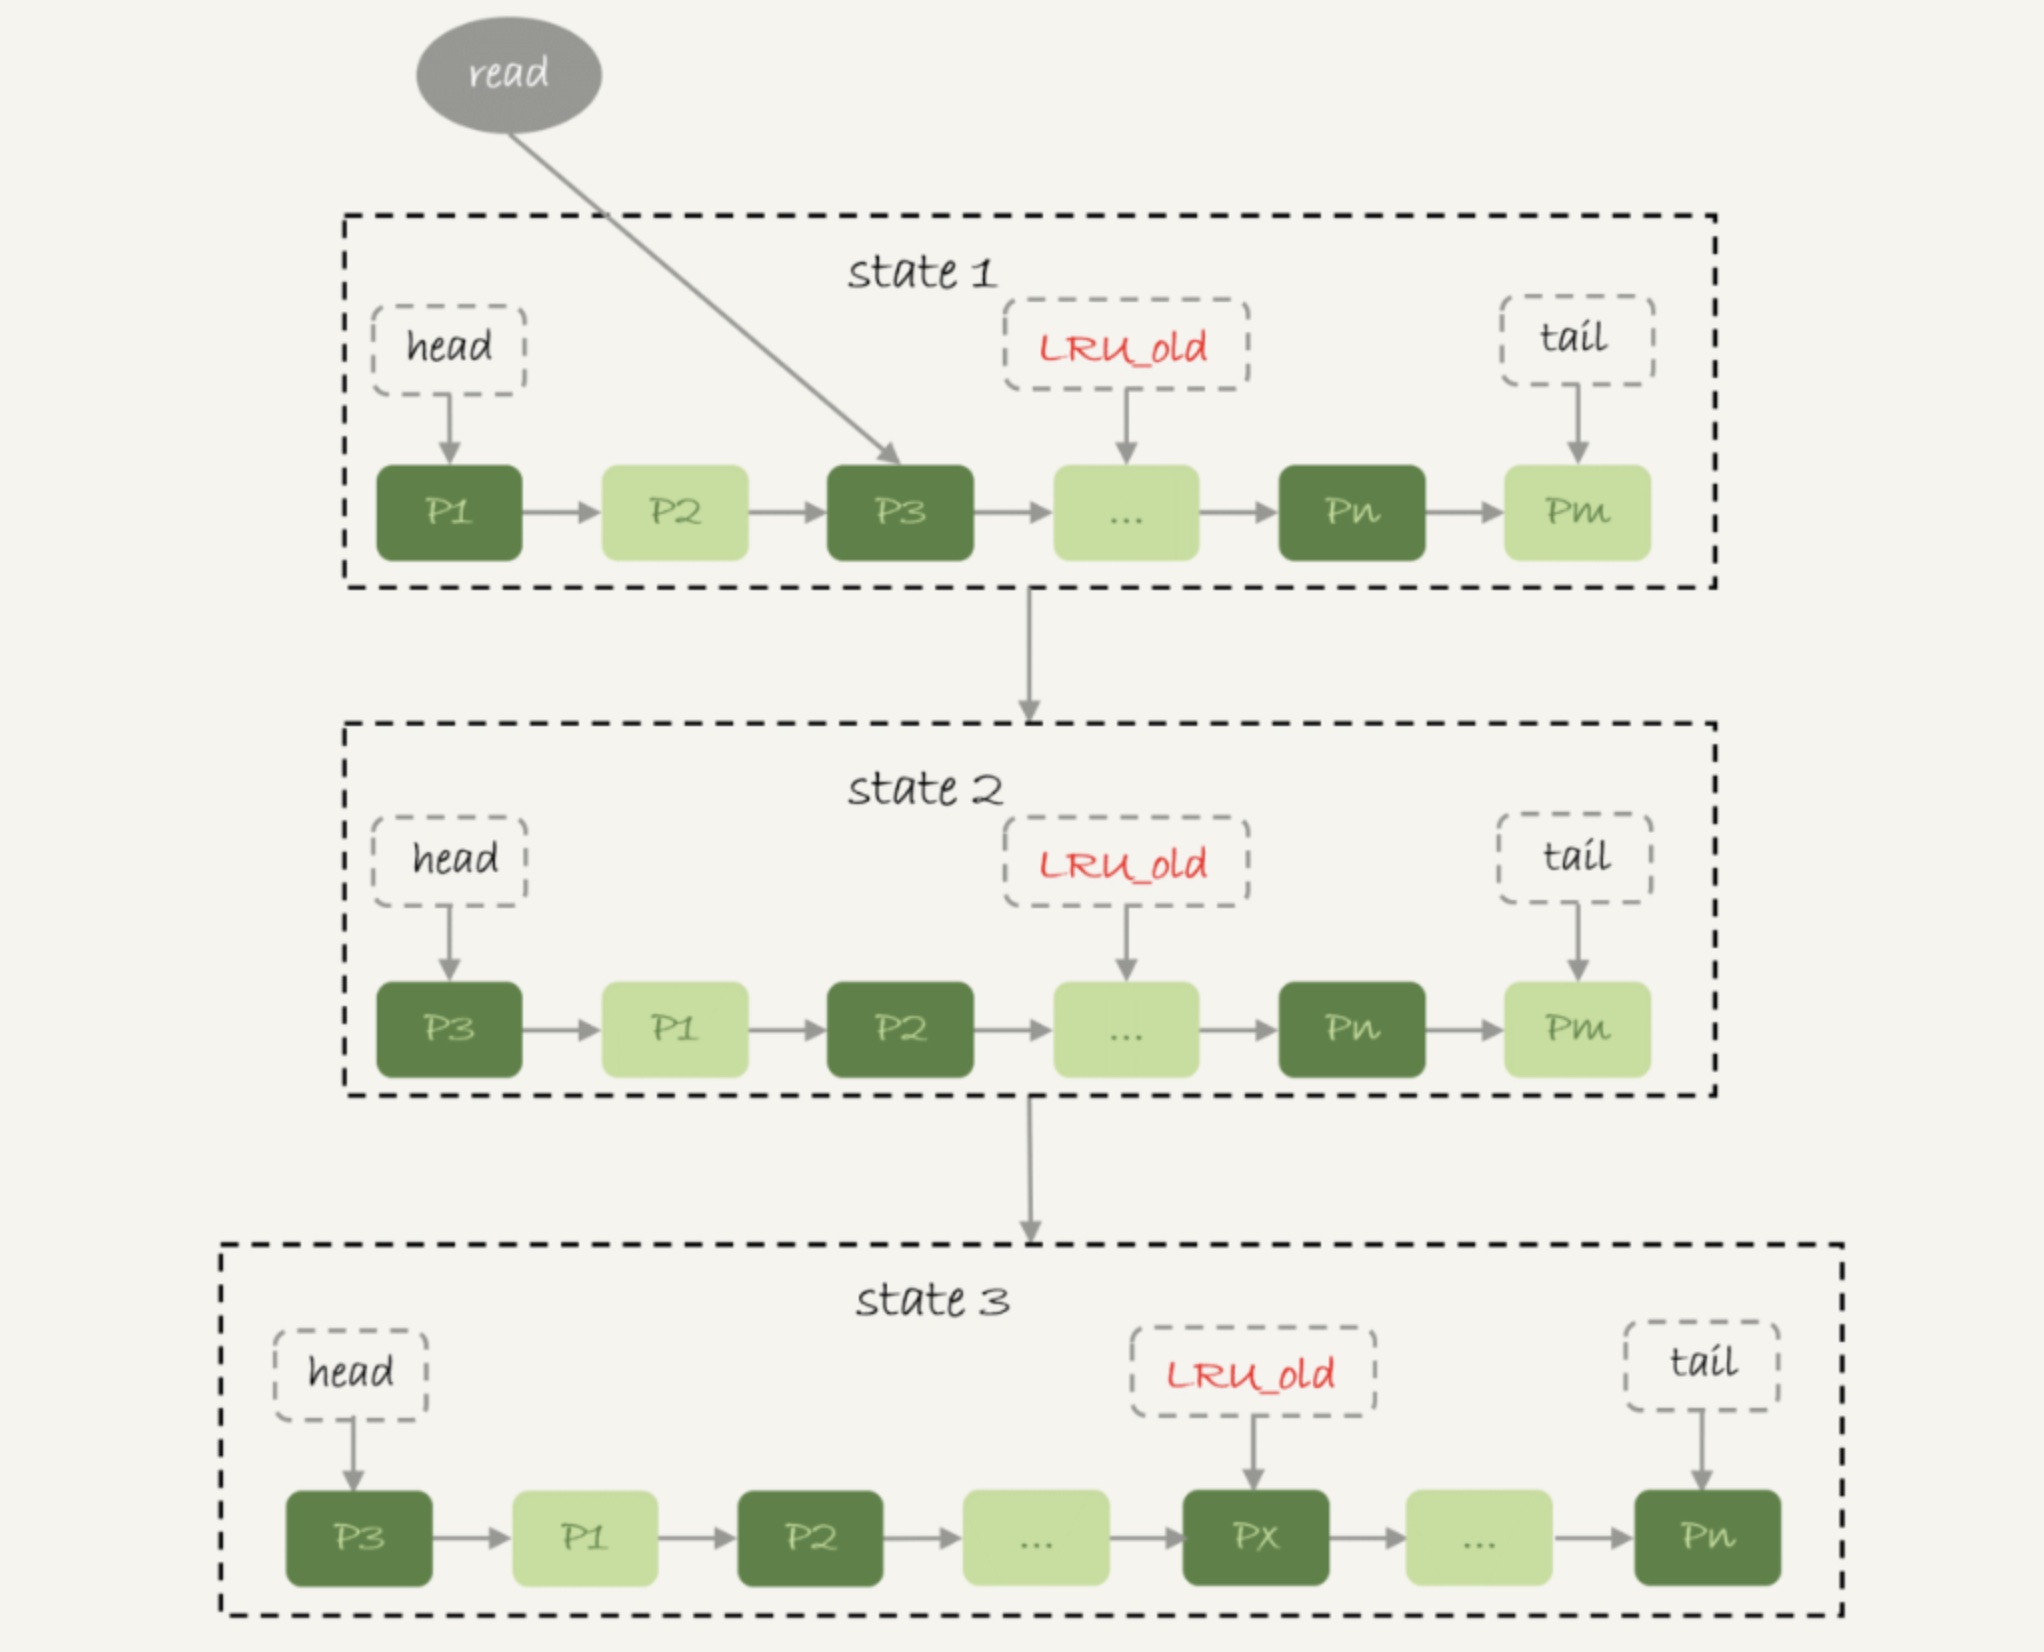
InnoDB内存管理使用LRU算法,这个算法的核心就是淘汰最久未使用的数据。按5:3的比例将整个LRU链分成了young区域和old区域,改进后的算法,不会导致有大量的页被淘汰。
表之间的join
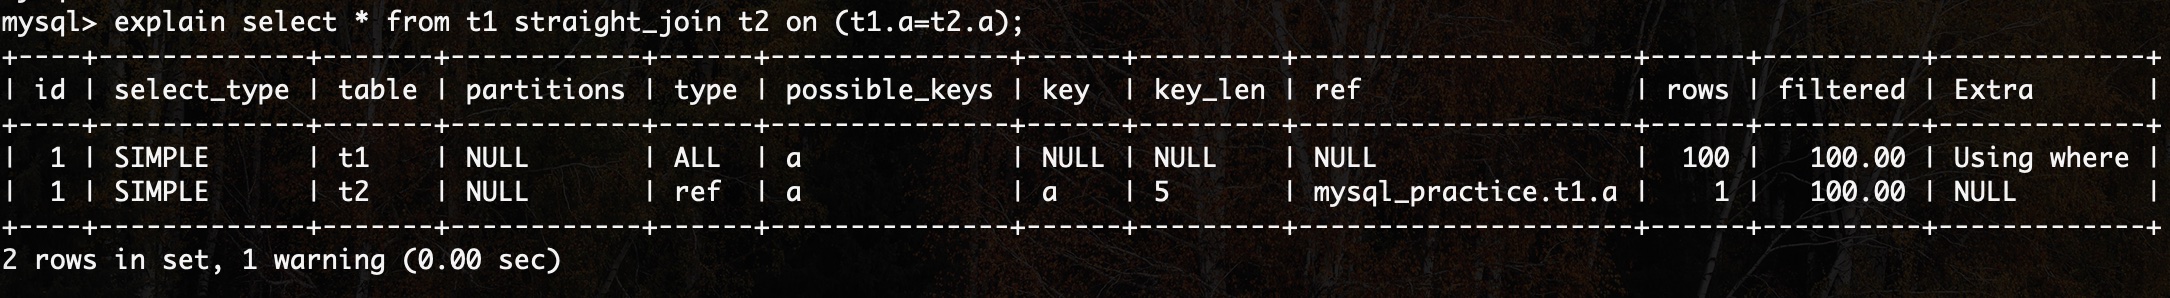
index nested-loop join:join的两张表都能使用上索引,其explain执行计划如下所示:
select * from t1 straight_join t2 on (t1.a=t2.a);
计算逻辑:先遍历t1表,从数据行中取出字段a的值,去表t2中查找满足条件的记录,并且在join的过程中,可以使用上被驱动表的索引。
思考,join为什么要选择小表?驱动表的行数是N,然后对于每一行,到被驱动表上匹配一次,在被驱动表上查一行的时间复杂度是2*log2M,因此整个执行过程,近似复杂度是N + N*2*log2M,显然主表N的影响更大。
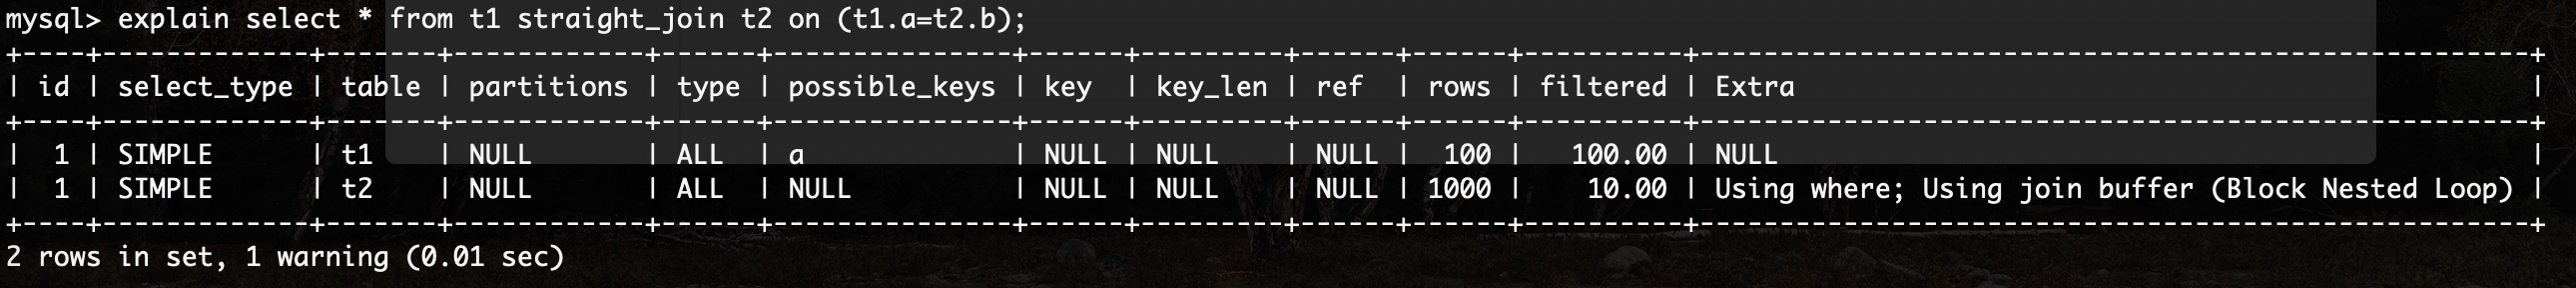
block nested-loop join:被join的表使用不上索引,其explain执行计划如下所示,在Extra中会展示Block Nested Loop:
select * from t1 straight_join t2 on (t1.a=t2.b);
计算逻辑:会将驱动表加载到内存join buffer(由join_buffer_size设定的,默认值是256k,超过就要分段)中,然后扫描表t2,将t2中的每一行与join buffer中的数据做对比,满足join条件的,做为结果集的一部分返回。
思考,join为什么要选择小表?尤其是在大表上的join操作,这样可能要扫描被驱动表很多次,会占用大量的系统资源,因此也建议使用小表做为join表。
MRR优化(Multi-Range Read)
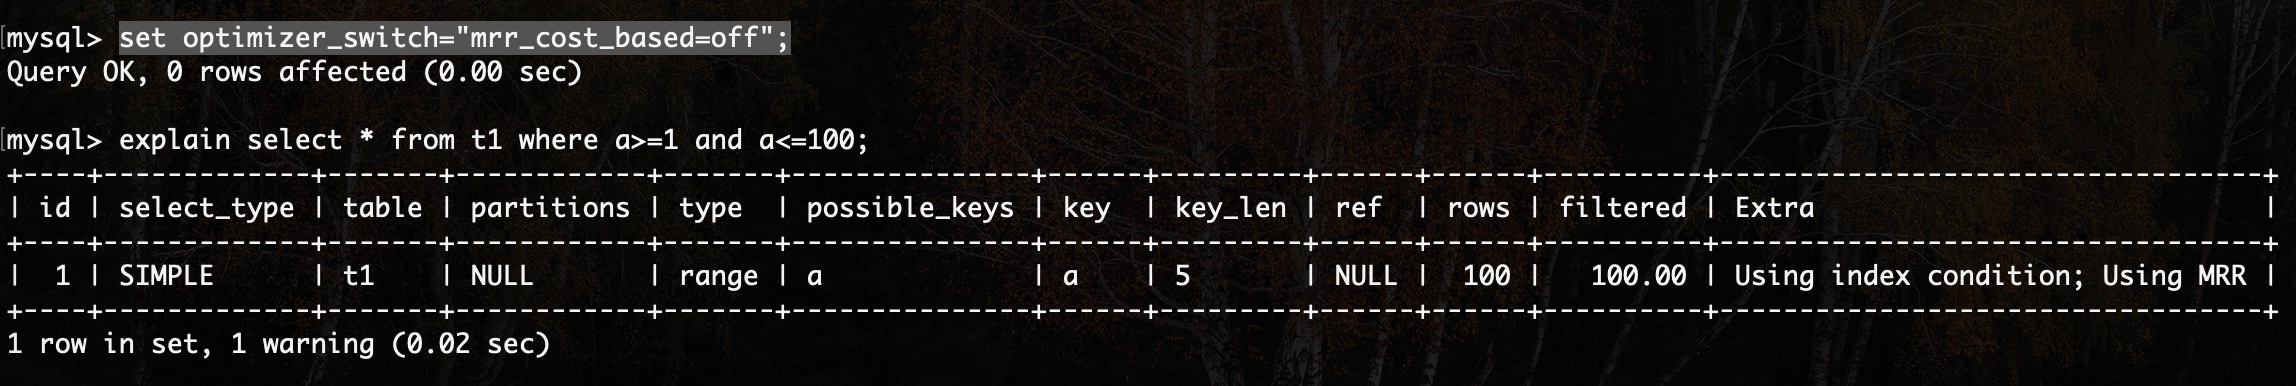
此优化的目的是尽量使用顺序读盘,大多数的数据都是按照主键递增顺序插入的,所以,按照主键的递增顺序查询能够提升读性能。
set optimizer_switch="mrr_cost_based=off";
BNL转BKA,添加索引
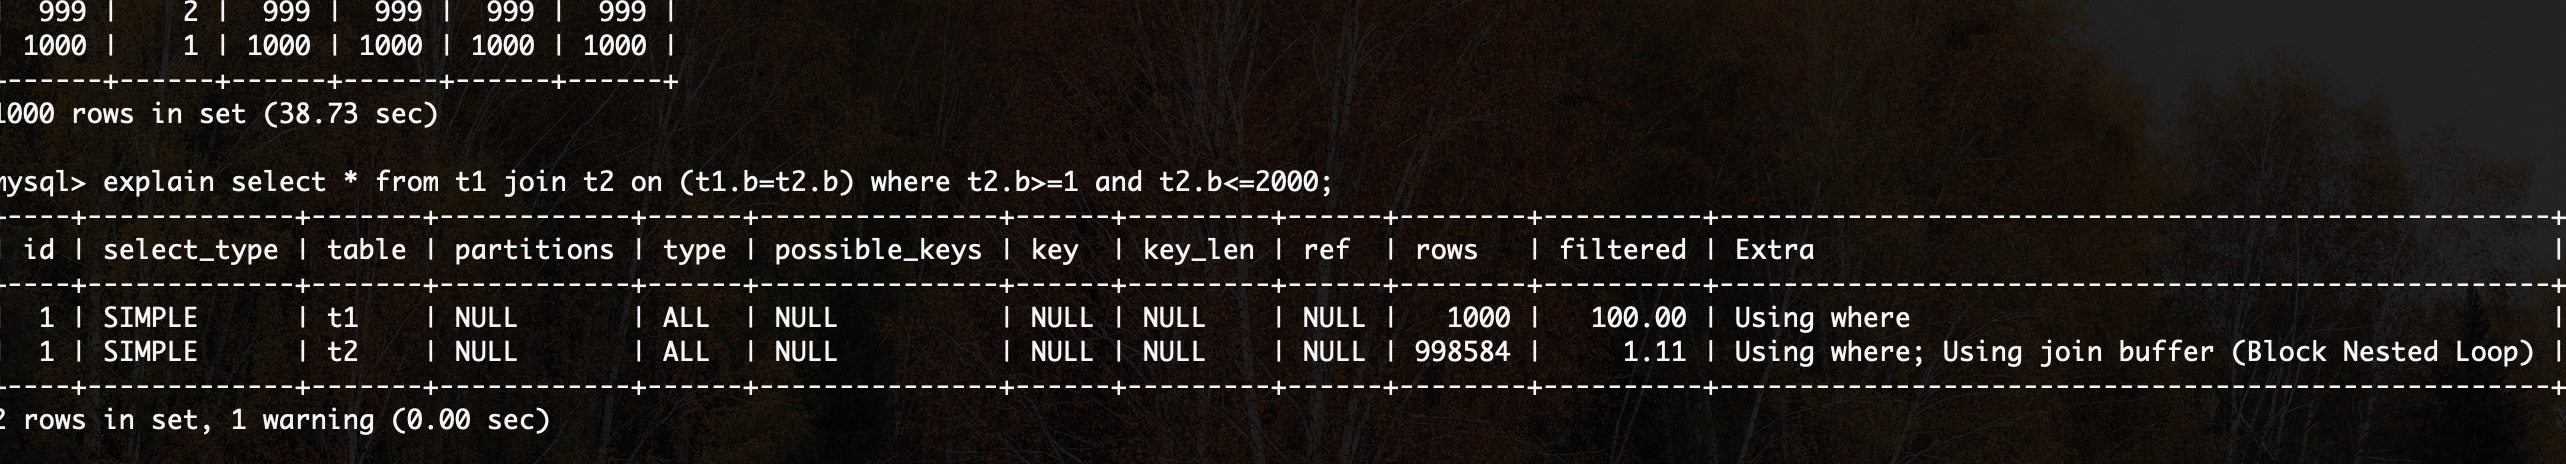
有些时候,会碰到一些不适合在被驱动表建索引的情况,看执行计划和实际执行,查询速度是比较慢的(sql执行接近38.37s)。
select * from t1 join t2 on (t1.b=t2.b) where t2.b>=1 and t2.b<=2000;
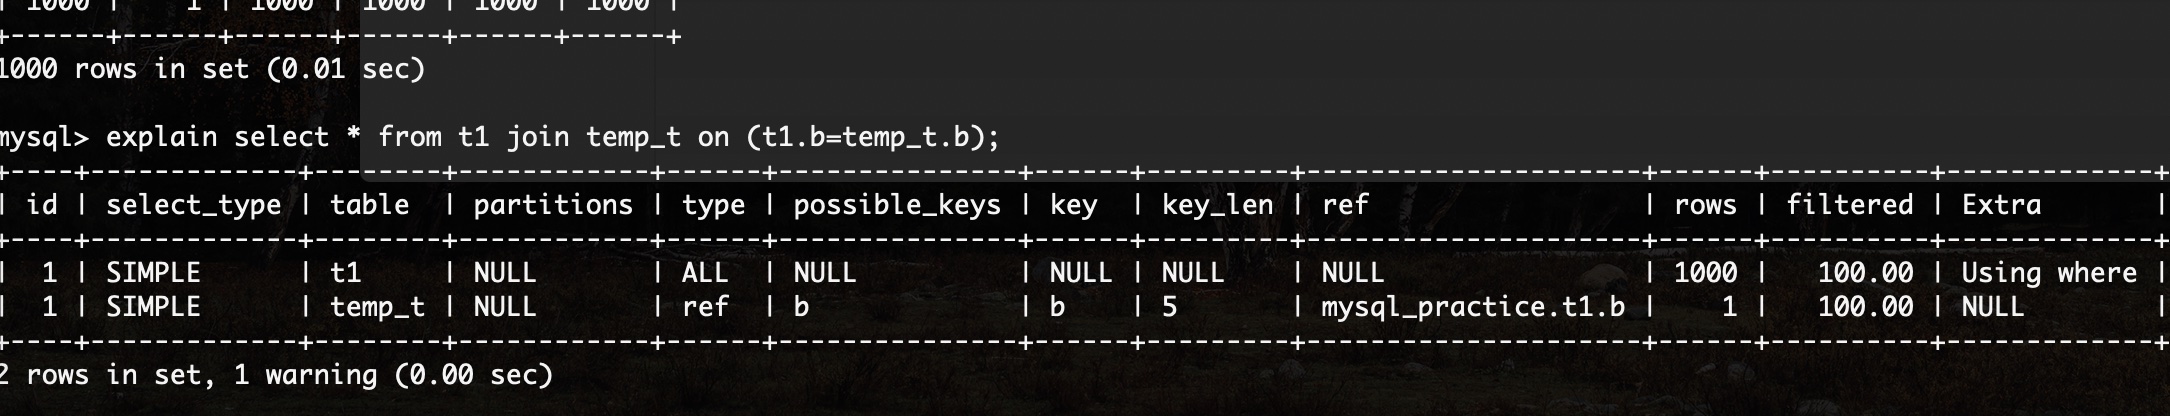
优化方式,使用临时表,然后再临时表上创建索引,最终执行时间不到0.1s。
临时表和内部临时表
- 建表语法是
create temporary table...,一个临表只能被创建它的session访问,对其它线程不可见; - 临时表可以与普通表重名,同名时
show create语句展示的是临时表; show tables命令不显示临时表,临时表前缀是:#sql{进程 id}{线程 id} 序列号;
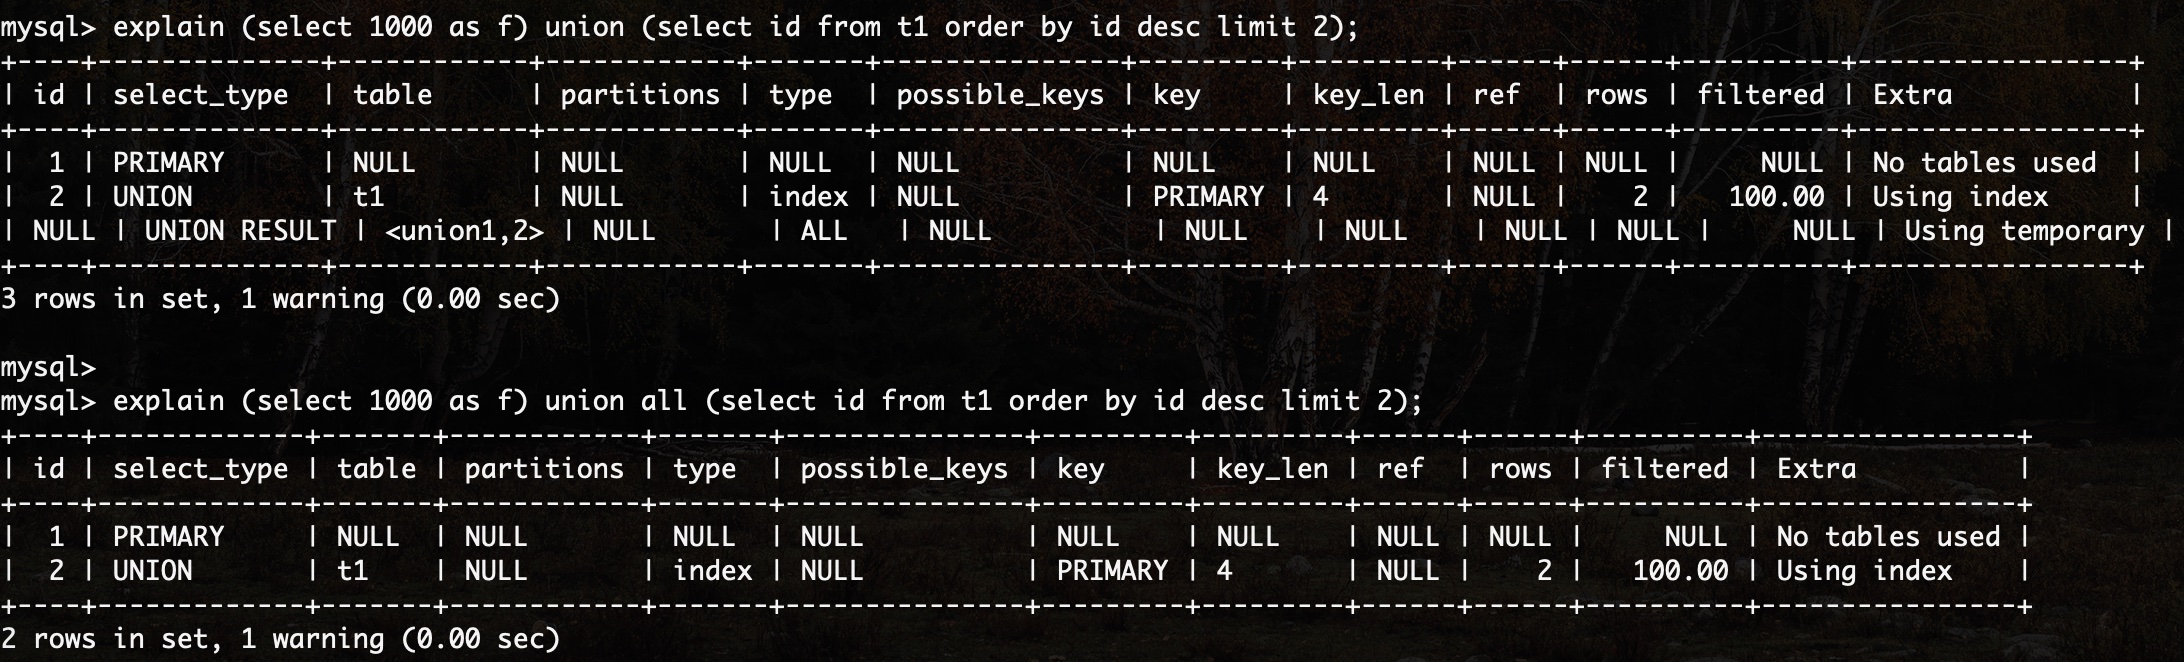
执行union语句时会用到临时表,其执行计划如下,在Extra中含有Using temporary,使用临时表主要是为了去重,向临时表写入已存在的id值时,
会拒绝写入。在union all中则不会使用临时表。
(select 1000 as f) union (select id from t1 order by id desc limit 2);
优化group by 查询,在MySQL 5.7版本支持了generated column机制,用来实现列数据的关联更新。
alter table t1 add column z int generated always as(id % 100), add index(z);
/* 重新按group by查询 */
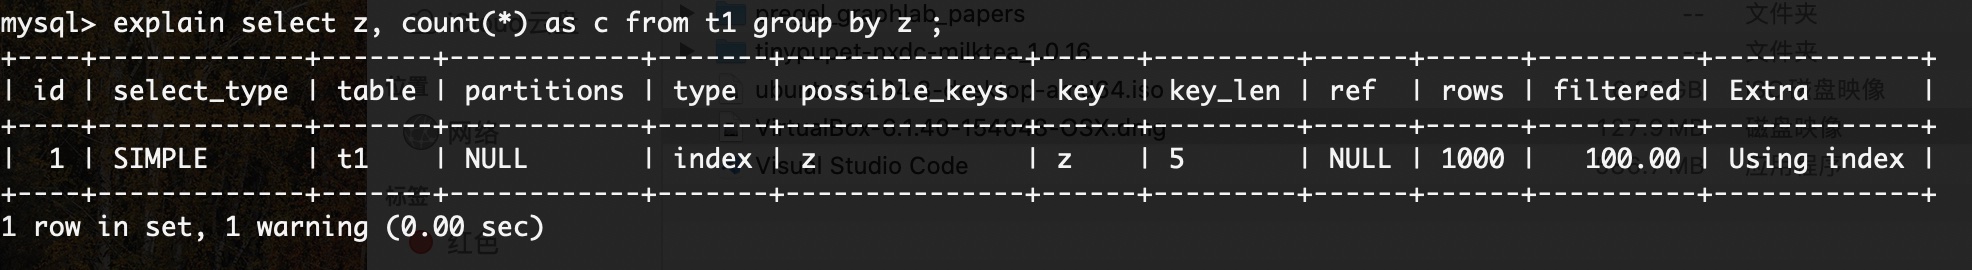
select z, count(*) as c from t1 group by z;

优化后,看sql的执行计划,在Extra中已经没有Using temporary了,走的索引。
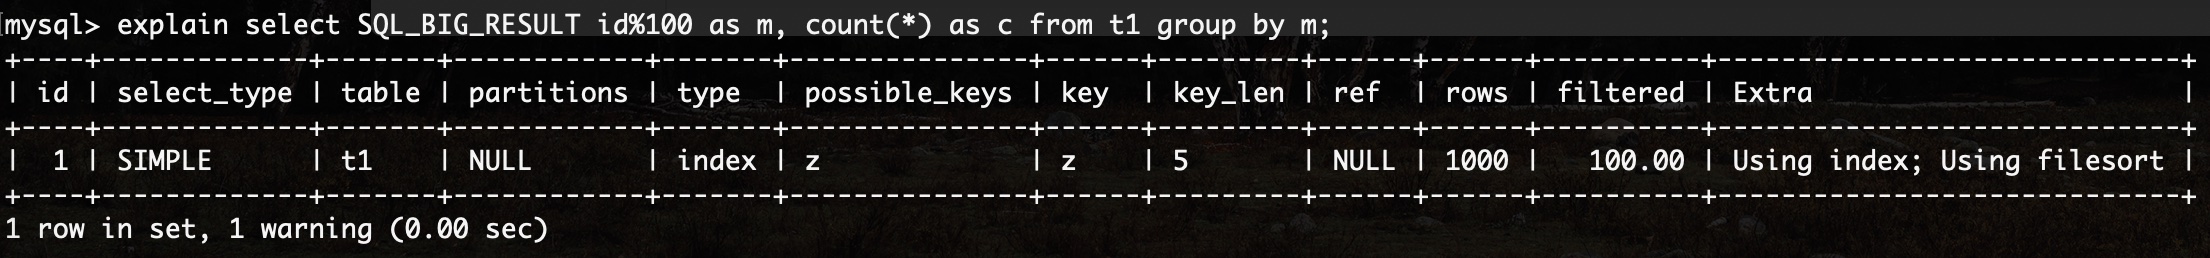
当group by的表不好加索引,并且临时表数据量特别大的,可以使用SQL_BIG_RESULT这个提示,告诉优化器,请直接用磁盘临时表。
select SQL_BIG_RESULT id%100 as m, count(*) as c from t1 group by m;