GraphRAG 检索增强生成
本目录阐述端到端的 GraphRAG 流水线:语料 → LLM 抽取实体关系 → Neo4j 图数据库 → 向量召回与 Cypher 遍历 → LLM 生成具备上下文引用的回答。 两条主线:Movie 演示线(langchain-neo4j 向量检索的最简形态)和医学 KG 演示线(neo4j-graphrag SimpleKGPipeline 自动抽取 + VectorRetriever/VectorCypherRetriever/GraphRAG 三种召回对比)。
Movie演示线(neo4j_movie_rag.py):采用langchain-neo4j在:Movie节点上构建向量索引并执行相似度检索,呈现”图数据库 + 向量检索”的最简形态。- 医学
KG演示线(neo4jrag/build_graph.py与neo4jrag/retrievers.py):采用neo4j-graphrag的SimpleKGPipeline自医学论文PDF中抽取实体关系,自动构建Chunk/ 实体节点与向量索引,并基于VectorRetriever/VectorCypherRetriever/GraphRAG三种召回范式进行对比。
LLM 在实体抽取阶段采用 gpt-5.6-luna(通过 a6api 代理调用),在回答生成阶段采用 deepseek-v4-pro(同属 OpenAI 兼容协议);embedding 一律经由 text-embedding-v3 输出(1024 维)。全部配置统一收敛于 common.py。
数据约定
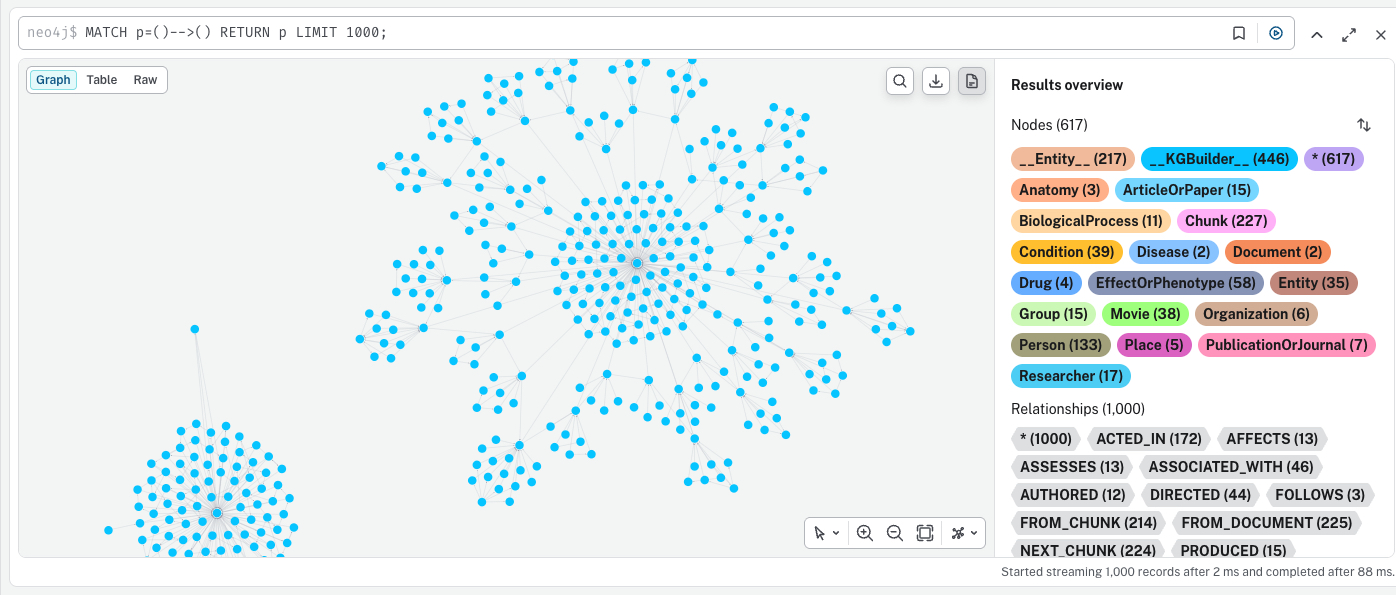
neo4jrag/data/*.pdf—— 医学论文biomolecules-11-00928.pdf,其余文件在build_graph.py中以注释形式列出)Movie数据源自Neo4j官方Movie示例数据库(默认neo4j#2026的本地实例通常已预置该库)- 图谱可视化(
Chunk节点与实体关系的拓扑形态):
一、前置知识
1.1 为何需要 GraphRAG
传统 RAG(”向量检索 + LLM 回答”)存在两项固有短板:
- 跨文档关系丢失:召回的内容为相似片段,但片段之间的语义关联(诸如”药物 A 治疗疾病 B,疾病 B 由基因 C 导致”)难以直接进入
prompt。 - 回答可解释性不足:用户仅可获得相似度分数,无法追溯知识图谱上的具体路径。
GraphRAG 的解决思路为:首先将语料构建为图谱,再于图上执行召回。召回阶段既能通过向量检索定位”语义相近的 Chunk“,亦可借助 Cypher 沿图遍历”与之相关的实体与关系”,最终将”文本 + 关系”一并注入 prompt。
1.2 Neo4j 与 Cypher
Neo4j 是一款原生图数据库:以 节点(Node) 与 关系(Relationship) 刻画实体与联系,节点可附带标签(如 :Person、:Disease),关系则具备方向与类型(如 TREATS、CAUSES)。Cypher 系 Neo4j 的查询语言,语法形似 SQL,但以图模式匹配为核心:
MATCH (d:Disease {name: "Lupus"})-[r:TREATS]-(drug:Drug)
RETURN drug.name, r.details
Neo4jBrowser(http://localhost:7474):用于可视化呈现Cypher查询结果。- bolt://localhost:7687:默认的
Bolt驱动端口(Python端经由neo4j.GraphDatabase.driver连接)。 - 数据库名:本目录默认连接至
neo4j(Neo4j自带的默认库)。
1.3 向量索引与 db.create.setNodeVectorProperty
Neo4j 5+ 内置向量索引能力(底层依赖 HNSW / Lucene)。Cypher 中的对应语法如下:
CREATE VECTOR INDEX movie_tagline_embeddings IF NOT EXISTS
FOR (m:Movie) ON (m.taglineEmbedding)
OPTIONS { indexConfig: {
    `vector.dimensions`: 1024,
    `vector.similarity_function`: 'cosine'
}}
- 向量维度须与
embedder输出一致(本目录统一采用 1024 维);若先前以其他维度创建过同名索引,需先执行DROP INDEX后再行创建。 - 向量写入:推荐采用内置过程
CALL db.create.setNodeVectorProperty(node, prop, vec),相较SET n.prop = vec更为稳健——该过程将同步维护索引状态。 - 向量检索:调用
CALL db.index.vector.queryNodes($index_name, $top_k, $vec) YIELD node, score以执行近似最近邻检索;score取值越高代表相似度越大(基于cosine相似度)。
1.4 neo4j-graphrag 生态
| 包 | 作用 |
|---|---|
neo4j_graphrag.SimpleKGPipeline |
一站式完成”分块 → 实体抽取 → embedding → 写图”全流程 |
neo4j_graphrag.llm.OpenAILLM |
兼容任意 OpenAI 兼容端点(OpenAI、a6api、DashScope、DeepSeek 等) |
neo4j_graphrag.embeddings.openai.OpenAIEmbeddings |
同上,embedding 亦走 OpenAI 兼容端点 |
neo4j_graphrag.indexes.create_vector_index |
通过编程方式创建向量索引 |
neo4j_graphrag.retrievers.VectorRetriever |
纯向量召回,返回 RetrieverResult.items |
neo4j_graphrag.retrievers.VectorCypherRetriever |
向量召回叠加 retrieval_query 所定义的 Cypher 逻辑,返回”文本 + 关联实体”两段拼接结果 |
neo4j_graphrag.generation.RagTemplate / GraphRAG |
LLM + retriever + prompt 的高阶封装,最终调用 .search(question).answer 取得答案 |
1.5 langchain-neo4j 与 Neo4jGraph
langchain_neo4j.Neo4jGraph 系 LangChain 生态中对 Neo4j 的轻量级封装,可通过 kg.query(cypher, params=...) 直接执行 Cypher,并将结果转换为 LangChain 的 Document。本目录中 neo4j_movie_rag.py 采用该 API——其无需 SimpleKGPipeline 的端到端流程,仅需”图 + 向量索引 + 检索”三件套。
1.6 节点标签冲突:Person 与 Researcher
SimpleKGPipeline 在运行时会自动为 entities 中每一个标签建立 UNIQUENESS 约束。Movie 示例数据库已预置 :Person 节点(即演员),若令 LLM 抽取出的”医学论文作者”亦使用 Person 标签,将因命名冲突而写入失败。
解决方案:于 build_graph.py 中将”人”对应的标签替换为自定义的 Researcher,既保留语义,又实现彻底隔离(详见 3.3 节)。
1.7 三种召回范式之对比
| 召回范式 | 召回内容 | 适用场景 | 实现位置 |
|---|---|---|---|
VectorRetriever |
仅 Chunk 节点的 text 属性 |
纯语义相似度匹配 | build_retriever() |
VectorCypherRetriever |
Chunk 文本与 1-2 跳关联实体关系(拼接为带分隔符的 info) |
期望 LLM 同时获取”原文 + 实体关系” |
build_vector_cypher_retriever() |
GraphRAG |
任一 retriever 的召回结果,结合 LLM 基于 prompt 生成的回答 |
端到端问答 | build_graph_rag() + GraphRAG.search() |
1.8 关键生态包
| 包 | 作用 |
|---|---|
neo4j |
原生 Python 驱动(GraphDatabase.driver) |
langchain-neo4j |
LangChain 适配层:Neo4jGraph、Cypher 工具链 |
neo4j-graphrag |
端到端 KG 构建、向量检索与 GraphRAG |
langchains/rag/chats/embeddings.py 中的 QwenEmbeddings |
LangChain 风格的 embedding 封装(按 10 条/批切分调用) |
neo4j_graphrag.embeddings.openai.OpenAIEmbeddings |
neo4j_graphrag 风格的 OpenAI 兼容 embedding |
二、目录结构与文件速查
| 文件 / 子目录 | 主题 | 概要 |
|---|---|---|
common.py |
共享配置 | Neo4j 连接与 Qwen embedding 配置;create_driver() / create_qwen_embedder() 工厂函数 |
neo4j_movie_rag.py |
Movie 向量 RAG(LangChain 风格) |
:Movie.taglineEmbedding 向量索引 + QwenEmbeddings + db.index.vector.queryNodes |
neo4jrag/build_graph.py |
端到端医学 KG 构建 |
SimpleKGPipeline 自 PDF 抽取实体/关系 → 写入 Neo4j + 自动构建 Chunk 向量索引 |
neo4jrag/retrievers.py |
三种召回与 GraphRAG |
VectorRetriever / VectorCypherRetriever / GraphRAG(由 DeepSeek 生成回答) |
neo4jrag/data/*.pdf |
医学论文语料 | 含 biomolecules-11-00928.pdf 等(默认仅处理首个文件) |
三、模块详解
3.1 common.py —— Neo4j + Qwen 共享配置
功能:避免在每个脚本中重复书写 Neo4j 连接信息与 Qwen embedding 配置。所有脚本统一从此模块导入 create_driver() / create_qwen_embedder() / EMBEDDING_DIMS 等。
关键配置
NEO4J_URI = "bolt://localhost:7687"
NEO4J_USERNAME = "neo4j"
NEO4J_PASSWORD = "neo4j#2026"
NEO4J_DATABASE = "neo4j"

QWEN_API_KEY = os.getenv("QWEN_API_KEY")               # 调用前须 export
QWEN_BASE_URL = "https://dashscope.aliyuncs.com/compatible-mode/v1"
QWEN_EMBEDDING_MODEL = "text-embedding-v3"
EMBEDDING_DIMS = 1024                                  # 必须与向量索引维度保持一致
两个工厂函数
def create_driver() -> neo4j.Driver:
    return neo4j.GraphDatabase.driver(NEO4J_URI, auth=(NEO4J_USERNAME, NEO4J_PASSWORD))

def create_qwen_embedder() -> OpenAIEmbeddings:
    return OpenAIEmbeddings(model=QWEN_EMBEDDING_MODEL, api_key=QWEN_API_KEY, base_url=QWEN_BASE_URL)
导入约定
- 同级脚本(
neo4j_movie_rag.py):from common import ...- 子目录脚本(
neo4jrag/*.py):from graphrags.common import ...(依赖于lingot/ 已加入sys.path)
3.2 neo4j_movie_rag.py —— Movie 节点向量 RAG(LangChain 风格)
功能:于 :Movie 节点的 taglineEmbedding 属性之上构建向量索引,采用 LangChain 的 QwenEmbeddings 将 tagline 向量化后回写 Neo4j;检索阶段则将 query 向量化后调用 db.index.vector.queryNodes 执行最近邻匹配。该实现不依赖 Neo4j GenAI 插件,亦不依赖 OpenAI embedding。
流程
movies:tagline
   └─> QwenEmbeddings.embed_documents(taglines)       # 内部按 10 条/批切分
        └─> MATCH (m:Movie {title:$t})
             CALL db.create.setNodeVectorProperty(m, 'taglineEmbedding', $v)
                  └─> vector index 由 Neo4j 自动维护

query
   └─> QwenEmbeddings.embed_query(question)
        └─> CALL db.index.vector.queryNodes($idx, $k, $vec)
             YIELD movie, score
             RETURN movie.title, movie.tagline, score
关键代码片段 1:构建向量索引(先 DROP 后 CREATE,以规避维度不一致导致的报错)
def setup_index() -> None:
    kg.query(f"DROP INDEX {INDEX_NAME} IF EXISTS")
    kg.query(f"""
        CREATE VECTOR INDEX {INDEX_NAME} IF NOT EXISTS
        FOR (m:Movie) ON (m.taglineEmbedding)

OPTIONS {{ indexConfig: {{
            `vector.dimensions`: {EMBEDDING_DIMS},
            `vector.similarity_function`: 'cosine'
        }}}}

    """)
关键代码片段 2:向量化与回写
movies = kg.query("""
    MATCH (movie:Movie) WHERE movie.tagline IS NOT NULL
    RETURN movie.title AS title, movie.tagline AS tagline
""")
vectors = qwen_embeddings.embed_documents([m["tagline"] for m in movies])
for title, vec in zip(titles, vectors):
    kg.query("""
        MATCH (m:Movie {title: $title})
        CALL db.create.setNodeVectorProperty(m, 'taglineEmbedding', $vector)
    """, params={"title": title, "vector": vec})
关键代码片段 3:检索
def vector_search(question: str, top_k: int = 5, embeddings = None):
    if embeddings is None:
        embeddings = QwenEmbeddings(model=EMBEDDING_MODEL)
    q_vec = embeddings.embed_query(question)
    return kg.query("""
        CALL db.index.vector.queryNodes($index_name, $top_k, $question_embedding)
        YIELD node AS movie, score
        RETURN movie.title AS title, movie.tagline AS tagline, score
    """, params={"index_name": INDEX_NAME, "top_k": top_k, "question_embedding": q_vec})
该流程体现”图 + 向量索引”的最小可行方案,不涉及
LLM抽取——Movie节点属人工导入的示例数据。下一节方为真正的”LLM抽取KG“流程。
3.3 neo4jrag/build_graph.py —— 端到端医学 KG 构建
功能:通过 SimpleKGPipeline 执行”PDF 切分 → LLM 抽取实体关系 → embedding → 写入 Neo4j“的完整流程。LLM 采用 OpenAI 兼容端点的 gpt-5.6-luna(a6api 代理),embedding 采用 text-embedding-v3。
Pipeline 结构
SimpleKGPipeline(
    llm=llm,
    driver=driver,
    text_splitter=FixedSizeSplitter(chunk_size=500, chunk_overlap=100),
    embedder=embedder,
    entities=NODE_LABELS,                # 27 个医学/学术/基础标签
    relations=REL_TYPES,                 # 6 种关系类型
    prompt_template=PROMPT_TEMPLATE,     # 指导 LLM 输出标准 JSON
    from_file=True,
)
标签体系(规避 Person 冲突)
BASIC_NODE_LABELS = ["Object", "Entity", "Group", "Researcher", "Organization", "Place"]
ACADEMIC_NODE_LABELS = ["ArticleOrPaper", "PublicationOrJournal"]
MEDICAL_NODE_LABELS = [
    "Anatomy", "BiologicalProcess", "Cell", "CellularComponent",
    "CellType", "Condition", "Disease", "Drug",
    "EffectOrPhenotype", "Exposure", "GeneOrProtein", "Molecule",
    "MolecularFunction", "Pathway",
]
NODE_LABELS = BASIC_NODE_LABELS + ACADEMIC_NODE_LABELS + MEDICAL_NODE_LABELS
为何弃用 Person:SimpleKGPipeline 在运行时会为 entities 中每一个标签建立 UNIQUENESS 约束(Movie 示例数据库自带 :Person 节点)。若医学论文中抽取的研究者与既有 Person 节点撞名,将被 Neo4j 直接拒绝写入。改用 Researcher 既保留语义,又实现彻底隔离。
关系类型
REL_TYPES = [
    "ACTIVATES", "AFFECTS", "ASSESSES", "ASSOCIATED_WITH",
    "AUTHORED", "BIOMARKER_FOR",
]
Prompt Template:要求 LLM 输出标准 JSON,id 字段统一采用字符串,关系方向遵循 start_node_id → end_node_id,并通过显式约束 Use only the following nodes and relationships —— 强制 LLM 仅使用预设的标签体系。
并行处理多个 PDF
results = await asyncio.gather(
    *(process_pdf(pipeline, path) for path in pdf_paths),
    return_exceptions=True,             # 单个文件失败不中断其他文件的处理
)
每个 PDF 各自执行一次完整 pipeline;return_exceptions=True 确保任一 PDF 失败时不影响其余 PDF 的处理。
日志:--log-level DEBUG 可观察每个 chunk 抽取所得的图谱、LLM 原始响应内容,以及 JSON 解析失败的详细原因。
⚠️ 重复执行会否覆盖既有数据:会。
SimpleKGPipeline以节点name作为主键,同名节点将被更新(upsert),不会无限堆积;然而若需”完整重跑”,须先执行MATCH (n) DETACH DELETE n清空数据库。
3.4 neo4jrag/retrievers.py —— 三种召回范式 + GraphRAG 生成
功能:在已构建的医学 KG 之上执行检索。三种召回范式分别演示一遍,并进一步通过 GraphRAG(以 DeepSeek 作为 LLM)端到端生成回答。
3 种召回与 GraphRAG 于 main() 中串联
def main():
    driver = create_driver()
    try:
        embedder = create_qwen_embedder()
        ensure_vector_index(driver, embedder)

        # 演示 1: 纯向量召回
        retriever = build_retriever(driver, embedder)
        vector_result = retriever.search(query_text=vector_question, top_k=5)
        print_vector_search_result(vector_result, vector_question, 5)

        # 演示 2: 向量召回叠加 Cypher 拉取关联实体关系
        vc_retriever = build_vector_cypher_retriever(driver, embedder)
        vc_res = vc_retriever.get_search_results(query_text=cypher_question, top_k=3)
        print_vector_cypher_result(vc_res, cypher_question, 3)

        # 演示 3: GraphRAG(基于前述两种 retriever,由 DeepSeek 生成回答)
        llm = create_llm()
        prompt_template = build_rag_prompt_template()
        v_rag  = build_graph_rag(llm, retriever, prompt_template)
        vc_rag = build_graph_rag(llm, vc_retriever, prompt_template)
        print_graph_rag_answers(rag_question,
            v_rag.search(rag_question, retriever_config={"top_k": 5}).answer,
            vc_rag.search(rag_question, retriever_config={"top_k": 5}).answer)
    finally:
        driver.close()
关键代码片段 1:VectorCypherRetriever 的 retrieval_query
VECTOR_CYPHER_RETRIEVAL_QUERY = """
WITH node AS chunk
MATCH (chunk)<-[:FROM_CHUNK]-()-[relList:!FROM_CHUNK]-{1,2}()
UNWIND relList AS rel
WITH collect(DISTINCT chunk) AS chunks,
     collect(DISTINCT rel) AS rels
RETURN '=== text ===\\n' + apoc.text.join([c in chunks | c.text], '\\n---\\n')
     + '\\n\\n=== kg_rels ===\\n'
     + apoc.text.join([r in rels |
         startNode(r).name + ' - ' + type(r) + '(' + coalesce(r.details, '') + ') -> '
         + endNode(r).name], '\\n---\\n') AS info
"""
- 以向量召回所得的
Chunk为起点,沿 非FROM_CHUNK关系向外遍历 1-2 跳(即避免重复穿越文档级边),收集关联实体 apoc.text.join(...)将列表以换行符为分隔拼合为单段文本=== text ===与=== kg_rels ===为约定的两段分隔符,便于上层按段打印Python三引号字符串中的\\n为字面反斜杠与字符n,经Cypher解析后转化为真实换行符
关键代码片段 2:DeepSeek LLM 工厂
DEEPSEEK_MODEL = "deepseek-v4-pro"
DEEPSEEK_BASE_URL = "https://api.deepseek.com"
DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")

def create_llm() -> LLM:
    return LLM(
        model_name=DEEPSEEK_MODEL,
        model_params={"temperature": 0},
        api_key=DEEPSEEK_API_KEY,
        base_url=DEEPSEEK_BASE_URL,
    )
通过 OpenAI 兼容端点调用;模型名称以 deepseek-v4-pro 为准(实际可用名称请参照 DeepSeek 官方文档)。
关键代码片段 3:强制”基于 Context 回答”的 prompt 模板
RAG_TEMPLATE = """Answer the Question using the following Context. Only respond with
information mentioned in the Context. Do not inject any speculative information not mentioned.

# Question:
{query_text}

# Context:
{context}

# Answer:
"""

def build_graph_rag(llm, retriever, prompt_template) -> GraphRAG:
    return GraphRAG(llm=llm, retriever=retriever, prompt_template=prompt_template)
四、环境变量
| 变量 | 用途 |
|---|---|
QWEN_API_KEY (DASHSCOPE_API_KEY) |
common.create_qwen_embedder()(Neo4j 链路) + langchains/rag/chats/embeddings.py 中的 QwenEmbeddings(Movie 链路) |
OPENAI_API_KEY |
可选;若不希望使用 build_graph.py 中硬编码的 a6api key,可通过 export 覆盖 |
DEEPSEEK_API_KEY |
neo4jrag/retrievers.py 中的 create_llm()(GraphRAG 生成阶段) |
Neo4j自身的NEO4J_URI/ 用户名 / 密码硬编码于common.py(本地默认值bolt://localhost:7687与neo4j#2026)。
五、端到端运行顺序
如需从零完整执行一次流水线,请按以下步骤操作:
# 0) 启动 Neo4j
#    - Docker: docker run -p 7687:7687 -p 7474:7474 \
#              -e NEO4J_AUTH=neo4j/neo4j#2026 neo4j:5
#    - 或使用本地服务(须确保 bolt://localhost:7687 可访问)

# 1) Movie 线:构建向量索引 + 写入向量 + 检索
python graphrags/neo4j_movie_rag.py

# 2) 医学 KG 线:实体抽取 + 写入 Neo4j
#    须确保 neo4jrag/data/biomolecules-11-00928.pdf 存在
.venv/bin/python -m graphrags.neo4jrag.build_graph

# 3) 医学 KG 线:三种召回 + GraphRAG
.venv/bin/python -m graphrags.neo4jrag.retrievers

# 4) 如需观察 LLM 抽取的内部细节,请附加 --log-level DEBUG
python -m graphrags.neo4jrag.build_graph --log-level DEBUG
六、学习路径建议
- 先行了解概念:阅读”一、前置知识”(
Neo4j/ 向量索引 /neo4j-graphrag生态)。 - 最小可运行示例:运行
neo4j_movie_rag.py—— 该流程不依赖LLM抽取,可直观呈现”图 + 向量索引 + 检索”的完整形态。 - 完整端到端流程:运行
neo4jrag/build_graph.py—— 实际执行一次LLM抽取,随后于Neo4jBrowser(http://localhost:7474)中观察:Chunk/:Disease/:Drug等节点与FROM_CHUNK/TREATS等关系。 - 召回范式对比:运行
neo4jrag/retrievers.py—— 比较同一query在三种retriever下的差异:纯文本召回 vs 文本 + 关系召回 vsLLM综合答案。