LLM MCP 协议实战
本目录围绕 Model Context Protocol(MCP)展开:用 weather/ 和 papers.py 两个 FastMCP 服务端演示工具与提示词两类原语,再用 chat_bot.py 演示标准 MCP 客户端如何接 stdio 服务并桥接到 LLM 的 function-calling。 MCP = LLM 与 Agent 之间多加一层统一标准:把工具/数据对接逻辑封装进中间层,一套工具可同时被 Claude Desktop、Cline、Cursor、chat_bot.py 等多种客户端复用,避免每个客户端各自适配一遍。
数据约定:
papers/papers_info.json——papers.py服务端在search_papers时落盘的 arXiv 论文缓存,体现 MCP “工具有状态” 的能力。
一、MCP 的作用与架构
MCP 是一套通用开放的协议,相当于在 LLM 和 Agent 之间加了一层,用于统一标准:
- 构建”原子
agent“的基石:把工具 / 数据对接逻辑封装进中间层 - 标准化与互操作性:一套工具可同时被
Claude Desktop、Cline、Cursor、chat_bot.py等多种客户端使用 - 数据和工具整合:避免每个客户端都各自适配一遍
LLM ↔ Tool
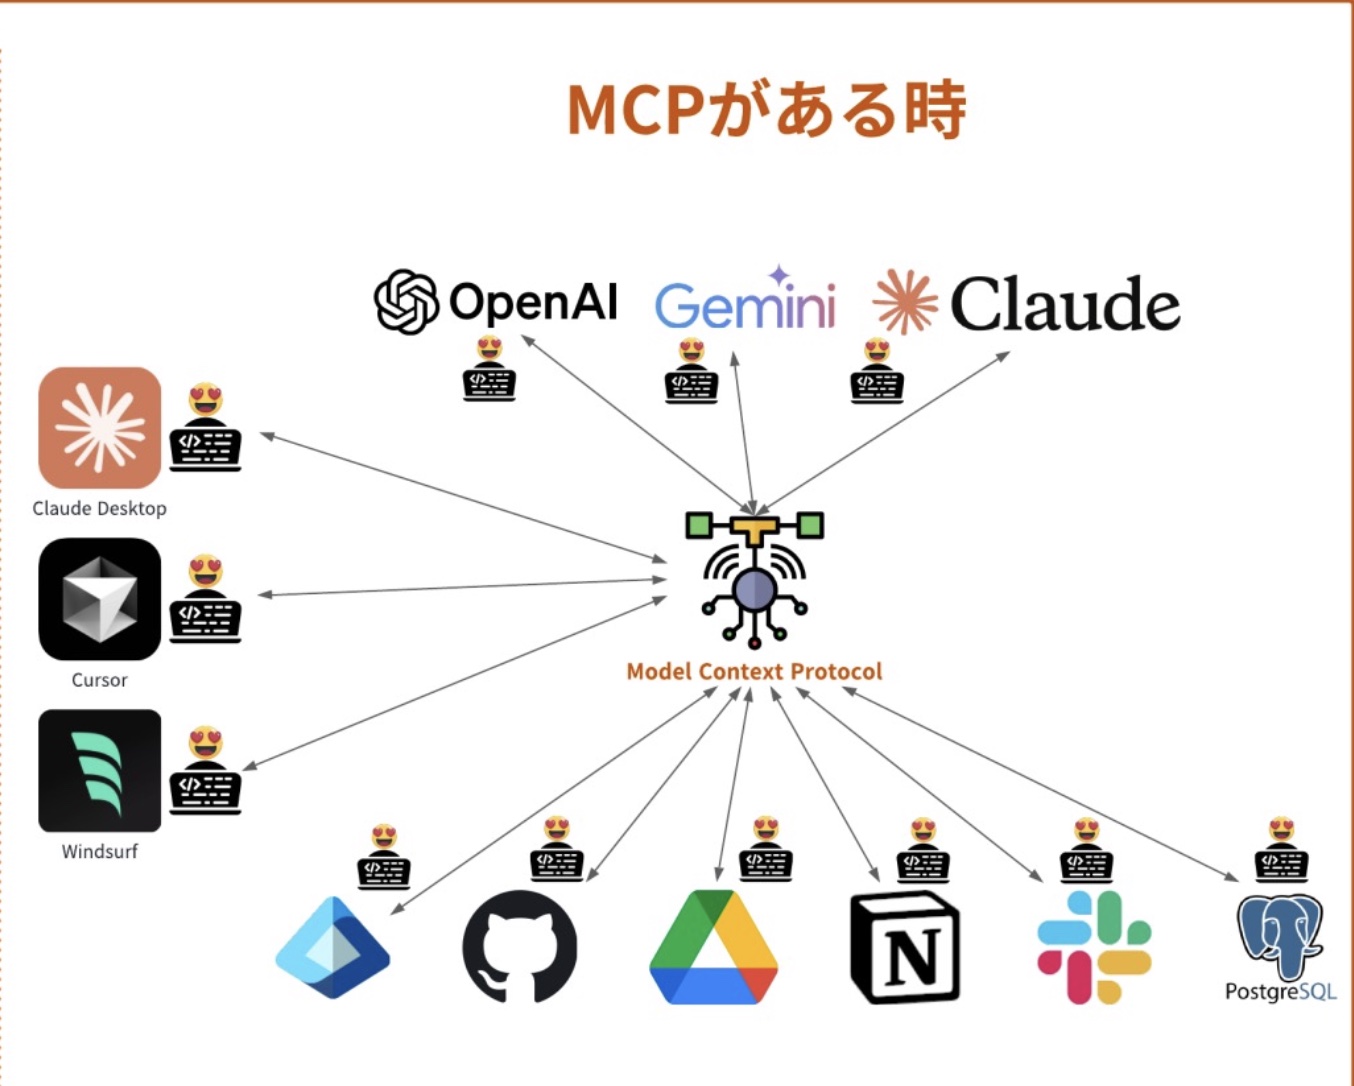
我的理解,mcp 相当于多加的 1 层,mcp 实现与各种大模型、各种 agents 适配,开发者只需要与 mcp 对接就行,将冗余、繁杂的对接逻辑放在 mcp 中间层。
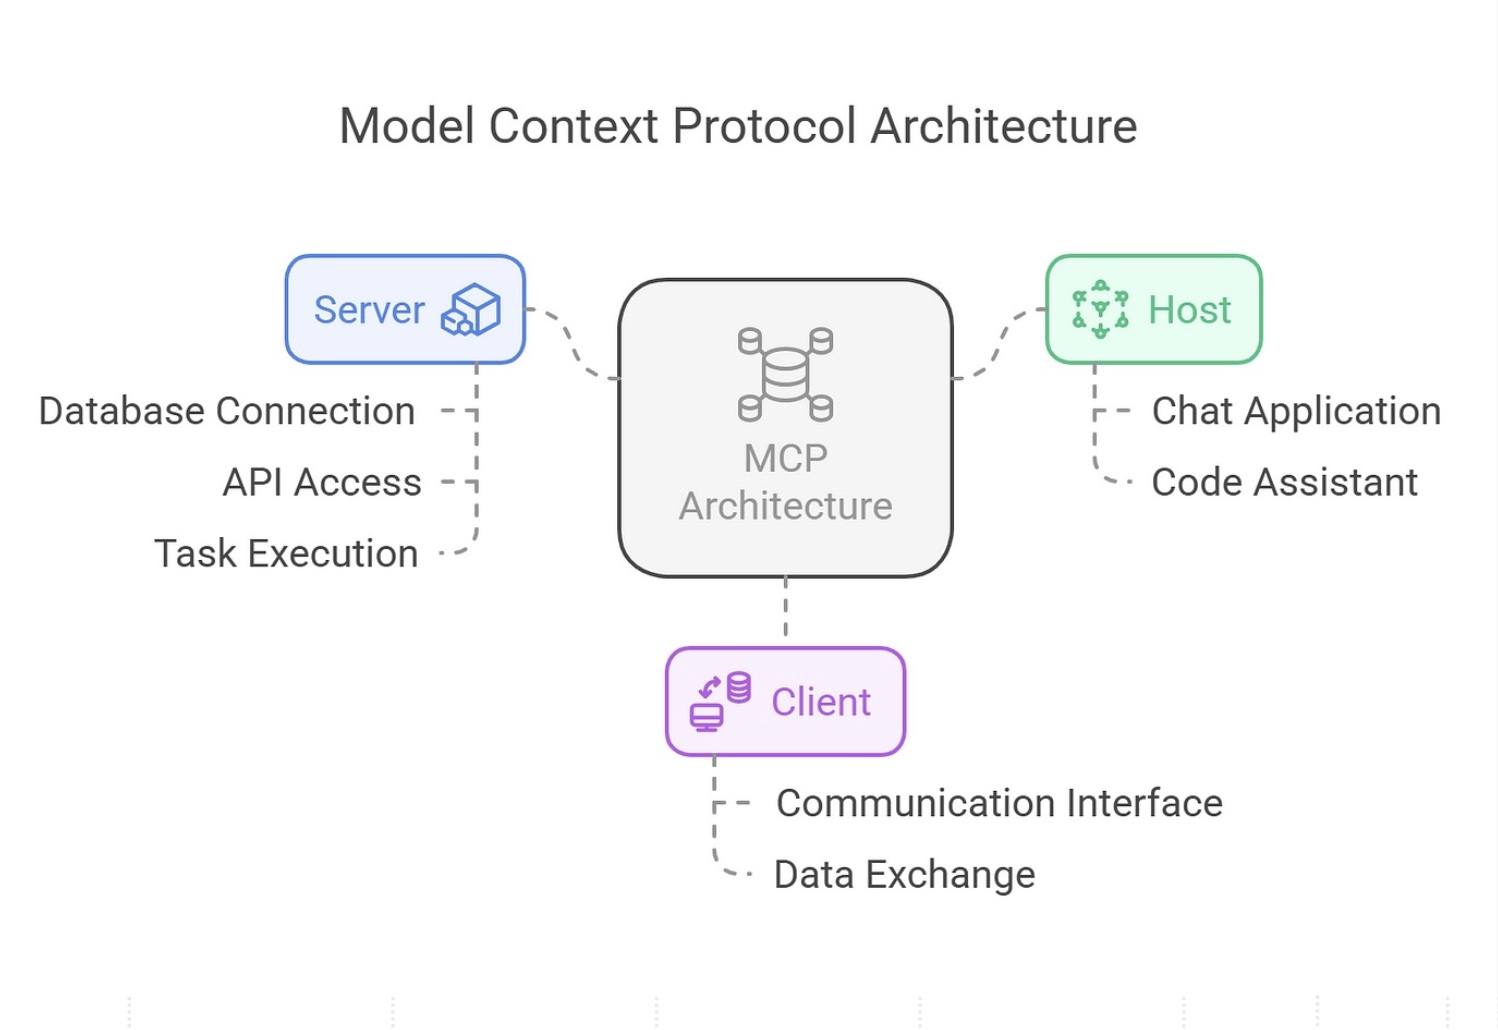
协议定位(高层视角)
┌─────────────────────────────────────────────────┐
│  客户端     Claude Desktop / Cline / Cursor / 自研  │
│  ┌──────────────────────────────────────────┐   │
│  │  LLM API  (OpenAI / DeepSeek / Anthropic)│   │
│  └──────────────────────────────────────────┘   │
│         ↑ function-calling 协议                  │
│  ─ ─ ─ ─ MCP Client SDK ─ ─ ─ ─ ─ ─ ─ ─ ─ ─    │
└──────────────│───────────────────────────────────┘
               │ stdio / SSE
┌──────────────│───────────────────────────────────┐
│  MCP Server  (FastMCP)                          │
│   • Tools    (function)                         │
│   • Resources (URI → data)                      │
│   • Prompts  (templated text)                   │
└─────────────────────────────────────────────────┘
二、前置知识
2.1 Function Calling(Tool Use)
让 LLM 在回复里 不直接给答案,而是输出结构化的”我想调哪个函数 + 参数”——再由客户端执行后把结果作为 ToolMessage 喂回。这是 tools.py、react.py、rag_agent.py、mcp_lab/chat_bot.py 都依赖的核心机制。OpenAI、DeepSeek、Anthropic 三家都遵守同一套语义,差别主要在参数 schema 的细节。
2.2 JSON Schema
工具的”参数模板”。OpenAI/Anthropic 的 function-calling 都用 JSON Schema 描述工具入参:
{
  "type": "object",
  "properties": {
    "topic":       {"type": "string",  "description": "..."},
    "max_results": {"type": "integer", "default": 5}
  },
  "required": ["topic"]
}
@tool(args_schema=SomePydanticModel) 会自动从 Pydantic 模型生成 JSON Schema;MCP 服务端的工具也按 JSON Schema 暴露。
2.3 传输方式(Transport)
| 传输 | 通信模型 | 适用场景 |
|---|---|---|
| stdio | 子进程标准输入输出 | 本地开发;Claude Desktop / Cline / Cursor;本目录 chat_bot.py 默认 |
| SSE(HTTP) | 服务端推送 EventStream | 远程部署;浏览器或多端客户端跨网络访问 |
| streamable-http | HTTP 流式 | MCP 1.x 新标准化方案(用法与 SSE 类似) |
mcp.run(transport="stdio") 或 mcp.run(transport="sse") 二选一;同一脚本可同时支持两种。
2.4 异步与子进程
MCP 客户端基于 asyncio 跑,子进程管理也是重点:
StdioServerParameters(command=..., args=..., env=...)描述如何启动服务端进程;stdio_client(server_params)上下文管子进程的创建与销毁;ClientSession(read, write)在 stdio pipe 上封装 JSON-RPC 风格的 RPC。
2.5 SDK 与高层封装
- 官方 MCP Python SDK:
mcp.server、mcp.client各自定义服务端与客户端接口。 FastMCP:官方提供的高层封装,用装饰器快速定义 Tools/Prompts/Resources。本目录所有服务端都基于FastMCP。- Inspector:
npx @modelcontextprotocol/inspector ...启动一个调试 Web UI,便于手动调用工具、查看 schema。
三、核心原语:Prompts / Resources / Tools
| 原语 | 方向 | 作用 | 本目录例子 |
|---|---|---|---|
| Prompts | 服务端预设 | 把”高质量提示词”封装在服务端,像函数一样被调用 | generate_search_prompt(papers.py) |
| Resources | 用户主动喂入 | 由客户端按 URI 拉取并插入上下文;只读,提供个性化的、静态的决策依据 | —(本目录未单独演示) |
| Tools | LLM 主动调用 | 模型通过 function-calling 触发;可读可改外部系统,”orchestrate”一系列工具调用 | search_papers / extract_info(papers.py)get_alerts / get_forecast(weather.py) |
Prompts:设定任务的框架和高质量的提问方式,给大模型输入提示词;Resources:由用户主动选择,将精准、可信的上下文喂给模型;Tools:模型理解了模板和偏好后,开始orchestrate(编排)一系列工具调用:”天气查询tool“、”机票查询tool” 等。
四、modelscope 社区 mcp 工具
除了自己写,也可以直接复用社区已经发布好的 MCP 服务:
- 国内天气
mcp:https://modelscope.cn/mcp/servers/@MrCare/mcp_tool 12306_mcp工具:https://modelscope.cn/mcp/servers/@Joooook/12306-mcp
五、目录结构与文件速查
| 文件 / 目录 | 角色 | 关键内容 |
|---|---|---|
README.md |
总览 | 协议原理 + 三大原语 + 模块详解 + Cline / Dify 实战(本文件) |
papers.py |
MCP 服务端 | FastMCP("research", port=8092);2 tools + 1 prompt;arXiv 缓存落盘 |
chat_bot.py |
MCP 客户端 | stdio 子进程 + ClientSession;MCP tools → OpenAI function-calling |
weather/weather.py |
MCP 服务端 | FastMCP("weather", host="0.0.0.0", port=8093);对接美国国家气象局 API |
papers/ |
持久化数据 | papers/<topic>/papers_info.json,由 search_papers 写入 |
六、模块详解
6.1 papers.py —— arXiv 论文检索 MCP 服务端
角色:FastMCP 服务端,端口 8092,同时演示 Tools + Prompts 两种原语,以及 stdio / sse 两种 transport。
启动
# 当前主入口是 sse 模式(端口 8092)
python papers.py

# stdio 模式: 把 mcp.run(transport='sse') 改为 'stdio' 即可

# 用官方 inspector 调试
npx @modelcontextprotocol/inspector uv run mcp_lab/papers.py
工具一:search_papers(topic, max_results=5)
调 arXiv API 搜论文 → 拍平成 dict → 按 topic 落盘到 papers/<topic>/papers_info.json → 返回论文 short_id 列表。
def _fetch_papers(topic: str, max_results: int):
    client = arxiv.Client()
    search = arxiv.Search(query=topic, max_results=max_results,
                          sort_by=arxiv.SortCriterion.Relevance)
    return list(client.results(search))

@mcp.tool()
def search_papers(topic: str, max_results: int = 5) -> list[str]:
    path = _paper_info_path(topic)                       # papers/<topic>/papers_info.json
    papers_info = _load_papers_info(path)
    ids = []
    for paper in _fetch_papers(topic, max_results):
        short_id = paper.get_short_id()
        ids.append(short_id)
        papers_info[short_id] = extract_paper_info(paper) # 拍平 title/authors/summary/pdf_url/published
    _save_papers_info(path, papers_info)
    return ids
工具二:extract_info(paper_id)
跨所有 topic 目录查找已缓存的论文,返回 JSON 字符串。
@mcp.tool()
def extract_info(paper_id: str) -> str:
    """Search for information about a specific paper across all topic directories."""
    for item in os.listdir(PAPER_DIR):
        item_path = os.path.join(PAPER_DIR, item)
        if not os.path.isdir(item_path): continue
        file_path = os.path.join(item_path, "papers_info.json")
        if not os.path.isfile(file_path): continue
        papers_info = _load_papers_info(file_path)
        if paper_id in papers_info:
            return json.dumps(papers_info[paper_id], indent=2)
    return f"There's no saved information related to paper {paper_id}."
提示词:generate_search_prompt(topic, num_papers=5)
把”如何搜论文并写出综述”这种高质量提示词封装在服务端,客户端可直接复用。
@mcp.prompt()
def generate_search_prompt(topic: str, num_papers: int = 5) -> str:
    """Generate a prompt for Claude to find and discuss academic papers on a specific topic."""
    return f"""Search for {num_papers} academic papers about '{topic}' using the search_papers tool.
Follow these instructions:
1. First, search for papers using search_papers(topic='{topic}', max_results={num_papers})
2. For each paper found, extract and organize the following information:
   - Paper title / Authors / Publication date
   - Brief summary of the key findings
   - Main contributions or innovations
   - Methodologies used / Relevance to the topic '{topic}'
3. Provide a comprehensive summary ...

Use clear formatting with headers, bullet points for easy readability."""
数据落盘目录
mcp_lab/papers/
└── computers/
    └── papers_info.json     ← search_papers("computers") 后生成
6.2 chat_bot.py —— 标准 MCP 客户端 + LLM function-calling
角色:MCP 客户端(stdio 模式),同时作为调用方桥接 gpt-4o。脚本通过 uv run mcp_lab/papers.py 启动子进程作为服务端,再用 MCP ClientSession 拿工具列表、转 OpenAI function-calling 格式、丢给 ChatOpenAI.bind_tools 进入对话循环。
启动
# 因为 client 用 uv run papers.py 作为子进程,推荐直接用 uv 启动
uv run mcp_lab/chat_bot.py
核心流程:MCP tools 转 OpenAI function-calling
import asyncio, sys
from pathlib import Path
from mcp import ClientSession, StdioServerParameters
from mcp.client.stdio import stdio_client

_MCP_SERVER = Path(__file__).parent / "papers.py"   # 绝对路径,与 CWD 无关

class MCP_ChatBot:
    def _openai_tools(self) -> list[dict]:
        """mcp 工具转 OpenAI function-calling 格式"""
        return [
            {"type": "function",
             "function": {"name": t["name"],
                          "description": t["description"],
                          "parameters": t["input_schema"]}}
            for t in self.available_tools
        ]

    async def connect_to_server_and_run(self):
        server_params = StdioServerParameters(
            command="uv",
            args=["run", str(_MCP_SERVER)],          # 绝对路径启动子进程
            env=None,
        )
        async with stdio_client(server_params) as (read, write):
            async with ClientSession(read, write) as session:
                self.session = session
                await session.initialize()
                response = await session.list_tools()
                self.available_tools = [
                    {"name": t.name, "description": t.description,
                     "input_schema": t.inputSchema}
                    for t in response.tools
                ]
                await self.chat_loop()
对话循环:process_query —— LLM 决策 → 调 MCP tool → 把结果当 ToolMessage 喂回
async def process_query(self, query):
    messages = [{"role": "user", "content": query}]
    llm_with_tools = self.llm.bind_tools(self._openai_tools())

    while True:
        response: AIMessage = await llm_with_tools.ainvoke(messages)
        messages.append(response)

        tool_calls = response.tool_calls or []
        if not tool_calls:
            if response.content: print(response.content)
            return                                     # 没有工具调用 → 直接回答

        for tc in tool_calls:
            result = await self.session.call_tool(tc["name"], arguments=tc["args"])
            content = "\n".join(
                getattr(block, "text", str(block)) for block in (result.content or [])
            )
            messages.append(ToolMessage(content=content, tool_call_id=tc["id"]))
        # 继续 while, 让 LLM 看到工具结果后再决定下一步
关键设计点
sys.stdout.reconfigure(errors="replace")—— LLM 返回的孤立 surrogate 字符不会让 stdout 崩。timeout=30, max_retries=1——OPENAI_API_KEY网络不通时不会无限等。_MCP_SERVER = Path(__file__).parent / "papers.py"—— 绝对路径,避免CWD不稳。tools是把 MCP 的 Anthropic 风格(name/description/input_schema)转成 OpenAI 的{"type": "function", "function": {...}}。
6.3 weather/weather.py —— NWS 天气查询 MCP 服务端
角色:FastMCP 服务端,监听 0.0.0.0:8093;对接美国国家气象局(api.weather.gov)公开 API,演示两种接入方式:VSCode + Cline(stdio,第七节)与 Dify(sse,第八节)。
通用 HTTP 助手
async def make_nws_request(url: str) -> dict[str, Any] | None:
    headers = {"User-Agent": USER_AGENT, "Accept": "application/geo+json"}
    async with httpx.AsyncClient() as client:
        try:
            r = await client.get(url, headers=headers, timeout=30.0)
            r.raise_for_status()
            return r.json()
        except Exception:
            return None
工具一:get_alerts(state) —— 获取某州的活跃天气预警
@mcp.tool()
async def get_alerts(state: str) -> str:
    """获取美国某个州当前生效的天气预警信息。state: 两个字母的美国州代码 (例如: CA, NY)。"""
    url = f"{NWS_API_BASE}/alerts/active/area/{state}"
    data = await make_nws_request(url)
    if not data or "features" not in data:
        return "无法获取预警信息或未找到相关数据。"
    if not data["features"]:
        return "该州当前没有生效的天气预警。"
    alerts = [format_alert(feature) for feature in data["features"]]
    return "\n---\n".join(alerts)
工具二:get_forecast(latitude, longitude) —— 三步链式调用取预报
@mcp.tool()
async def get_forecast(latitude: float, longitude: float) -> str:
    """根据经纬度获取天气预报。"""
    # 步骤 1: 经纬度 → forecast 端点 URL
    points = await make_nws_request(f"{NWS_API_BASE}/points/{latitude},{longitude}")
    if not points: return "无法获取该地点的预报数据。"

    # 步骤 2: 拉真正的预报数据
    forecast = await make_nws_request(points["properties"]["forecast"])
    if not forecast: return "无法获取详细的预报信息。"

    # 步骤 3: 取前 5 个 period 渲染成可读字符串
    periods = forecast["properties"]["periods"]
    return "\n---\n".join(
        f"{p['name']}: 温度 {p['temperature']}°{p['temperatureUnit']}"
        f" 风力 {p['windSpeed']} {p['windDirection']} {p['detailedForecast']}"
        for p in periods[:5]
    )
七、VSCode + Cline 实战
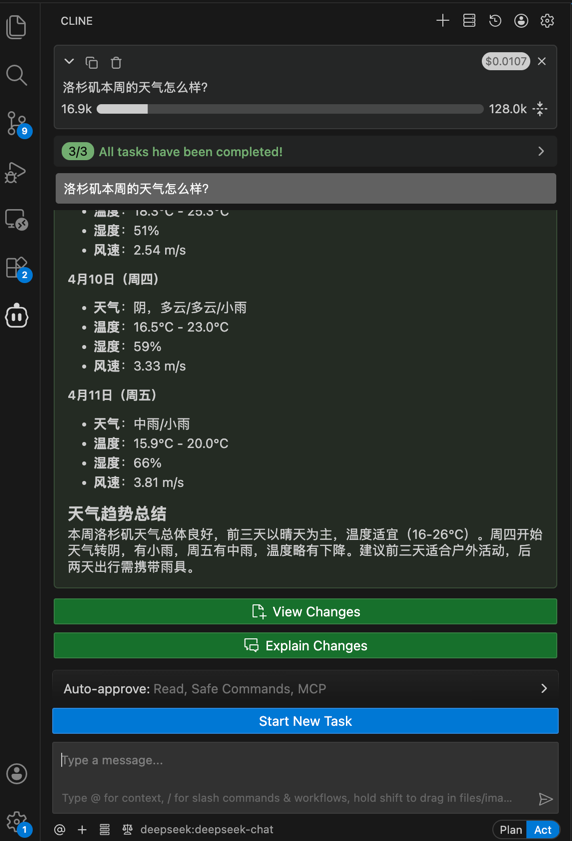
本地新建一个 mcp 天气查询的服务 weather.py ,mcp 工具使用 @mcp.tool() 来装饰,然后在 vscode 中安装 Cline 插件调用 MCP 服务。
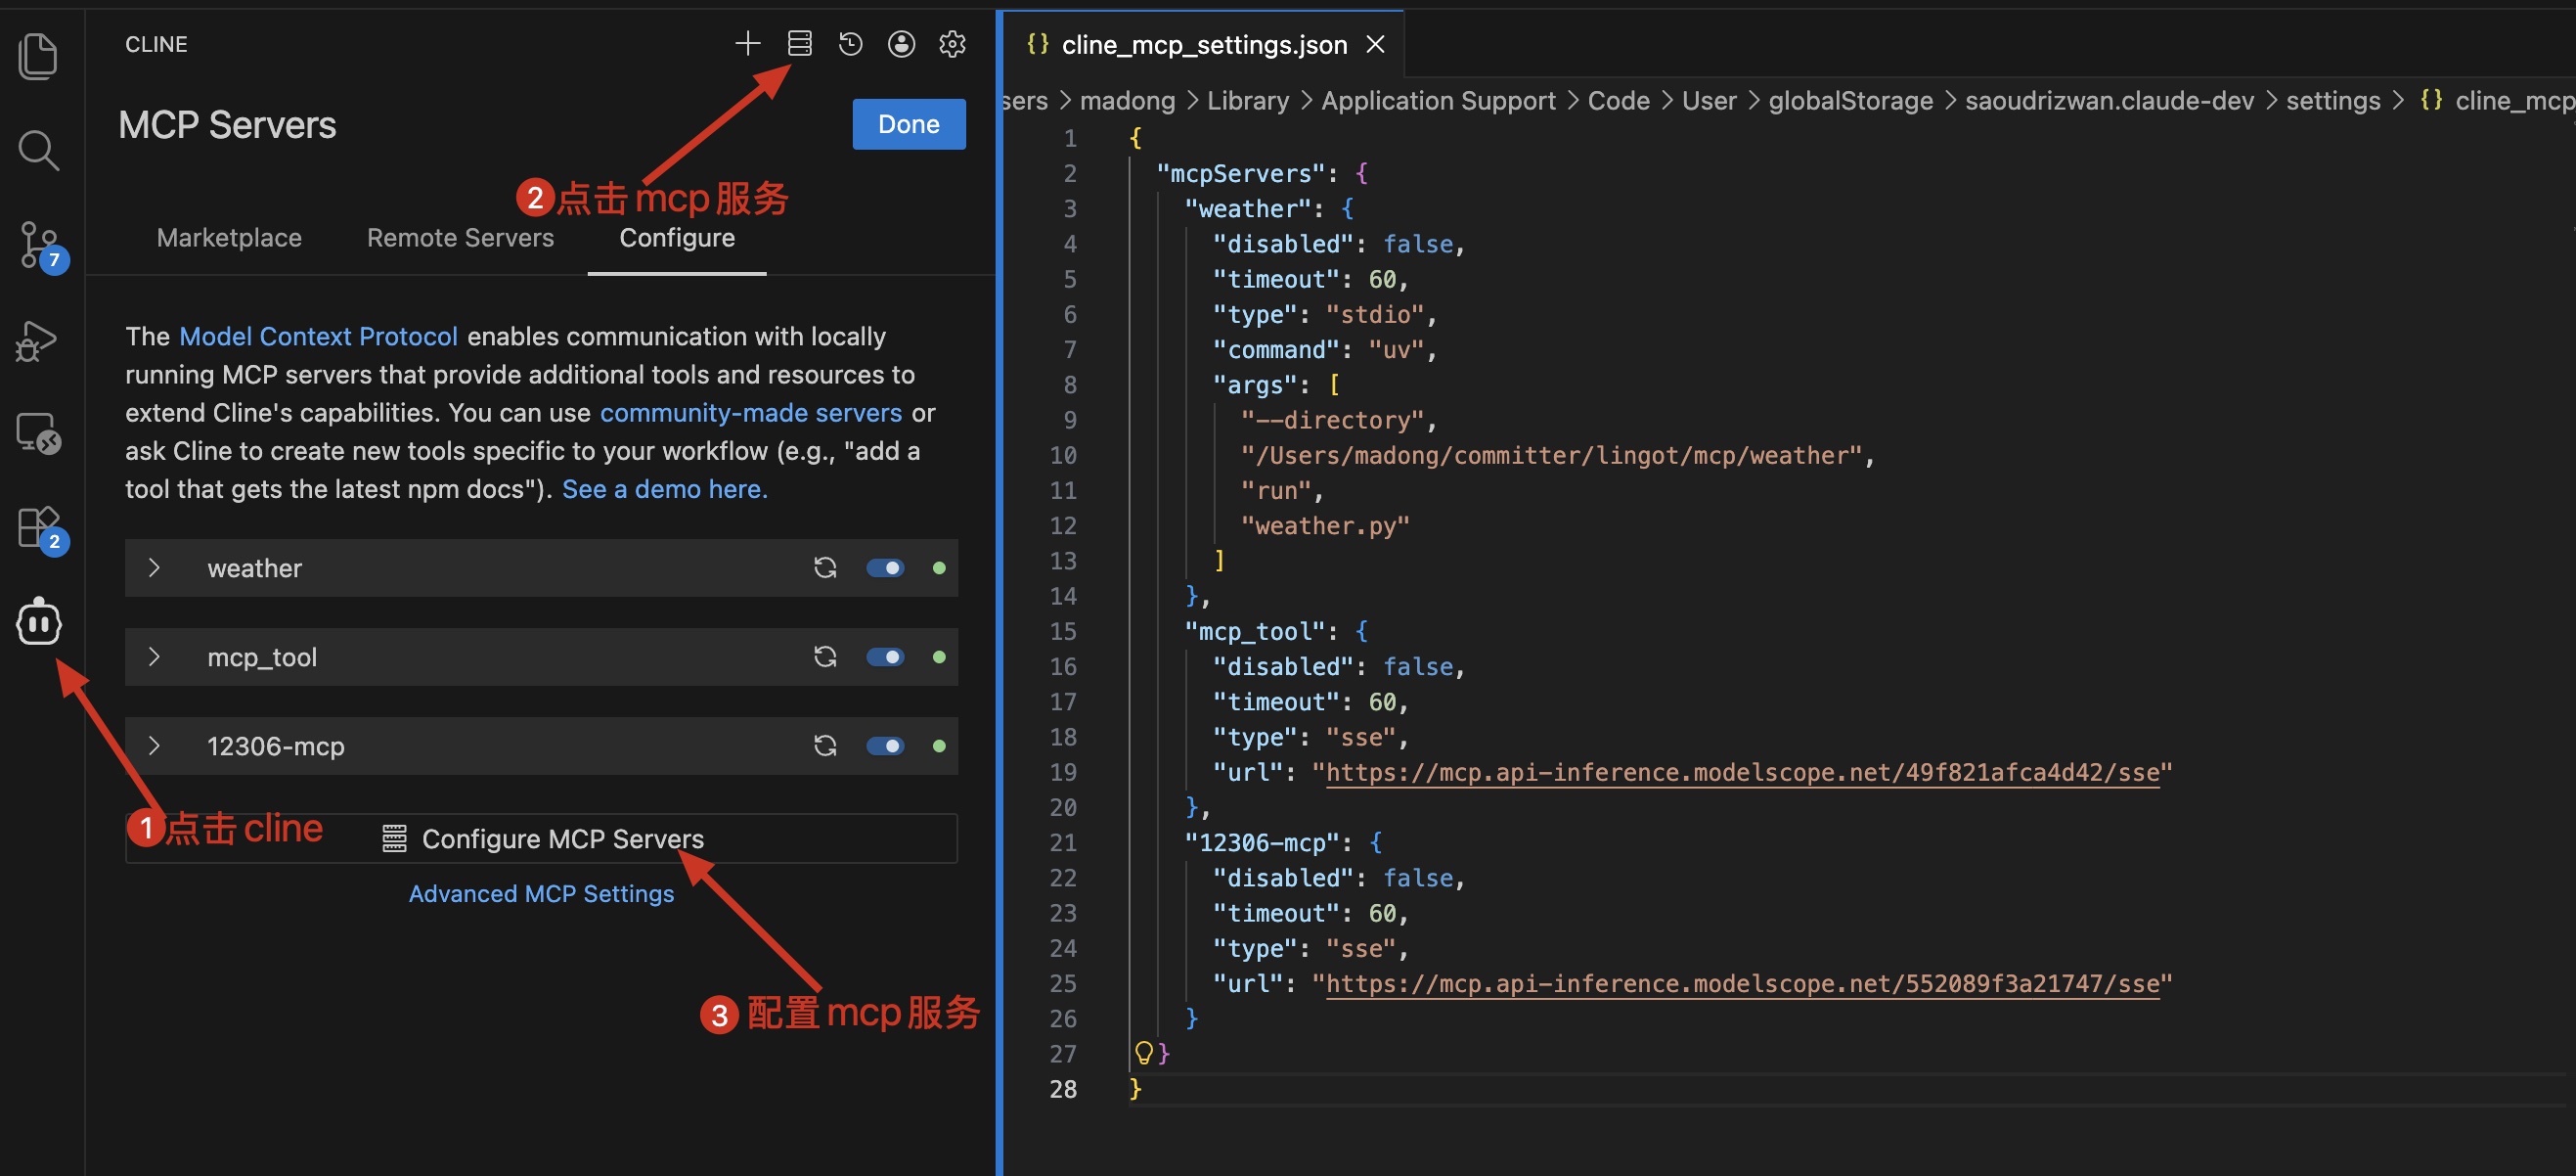
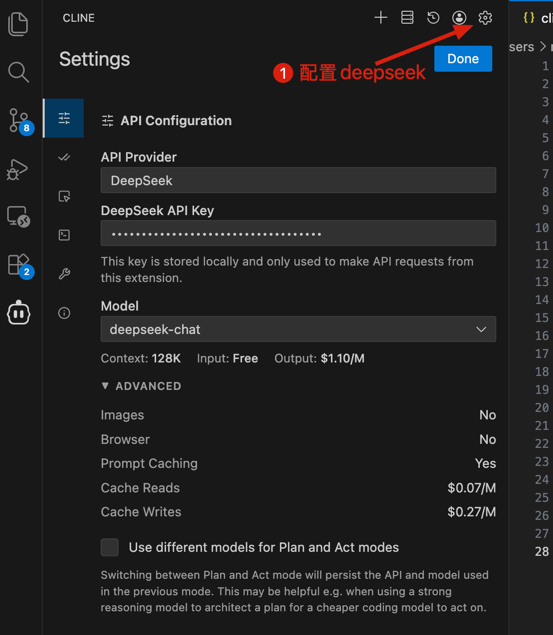
在 vscode 的配置中,可配置本地的 mcp 服务,也可配置远程例如 modelscope 生成的 mcp 链接。在 cline 中配置好 mcp 服务后,可以在 config 中配置要使用的大模型,如下方的 deepseek。
使用 cline 在前台通过 mcp 查询,问题”洛杉矶本周的天气怎么样?”,可以看到在对话框下方有 2 种模式,分别为 “Plan” 和 “Act“,当提问问题时,”Plan” 会分析出执行此任务的计划,”Act” 则会调用 mcp 执行实际的查询。
八、Dify 实战:注册并使用远程 MCP 工具
Cline 走的是 stdio(本地子进程),而 Dify 是独立部署的服务(通常还跑在 Docker 里),必须走 SSE(HTTP)方式远程接入。
8.1 服务端改造:host="0.0.0.0"
# mcp_lab/weather/weather.py
mcp = FastMCP("weather", host="0.0.0.0", port=8093)

if __name__ == "__main__":
    mcp.run(transport='sse')    # 远程部署用 sse 方式
两处改动缺一不可:
| 改动 | 原因 |
|---|---|
host="0.0.0.0" |
FastMCP 默认只绑 127.0.0.1,Dify(尤其是 Docker 容器内)会连不上;改成 0.0.0.0 才会监听所有网卡 |
transport='sse' |
Dify 的 MCP 客户端通过 HTTP 接入,无法像 Cline 那样拉起本地子进程 |
启动后 SSE 端点固定为 http://<本机局域网IP>:8093/sse:
# 启动 MCP 服务端
python mcp_lab/weather/weather.py

# 查本机 IP(macOS)
ipconfig getifaddr en0        # 例如 192.168.43.9
注意:Dify 用 Docker 部署时,
localhost指的是容器自身,必须填宿主机的局域网 IP(或host.docker.internal)。
8.2 在 Dify 中注册 MCP 服务
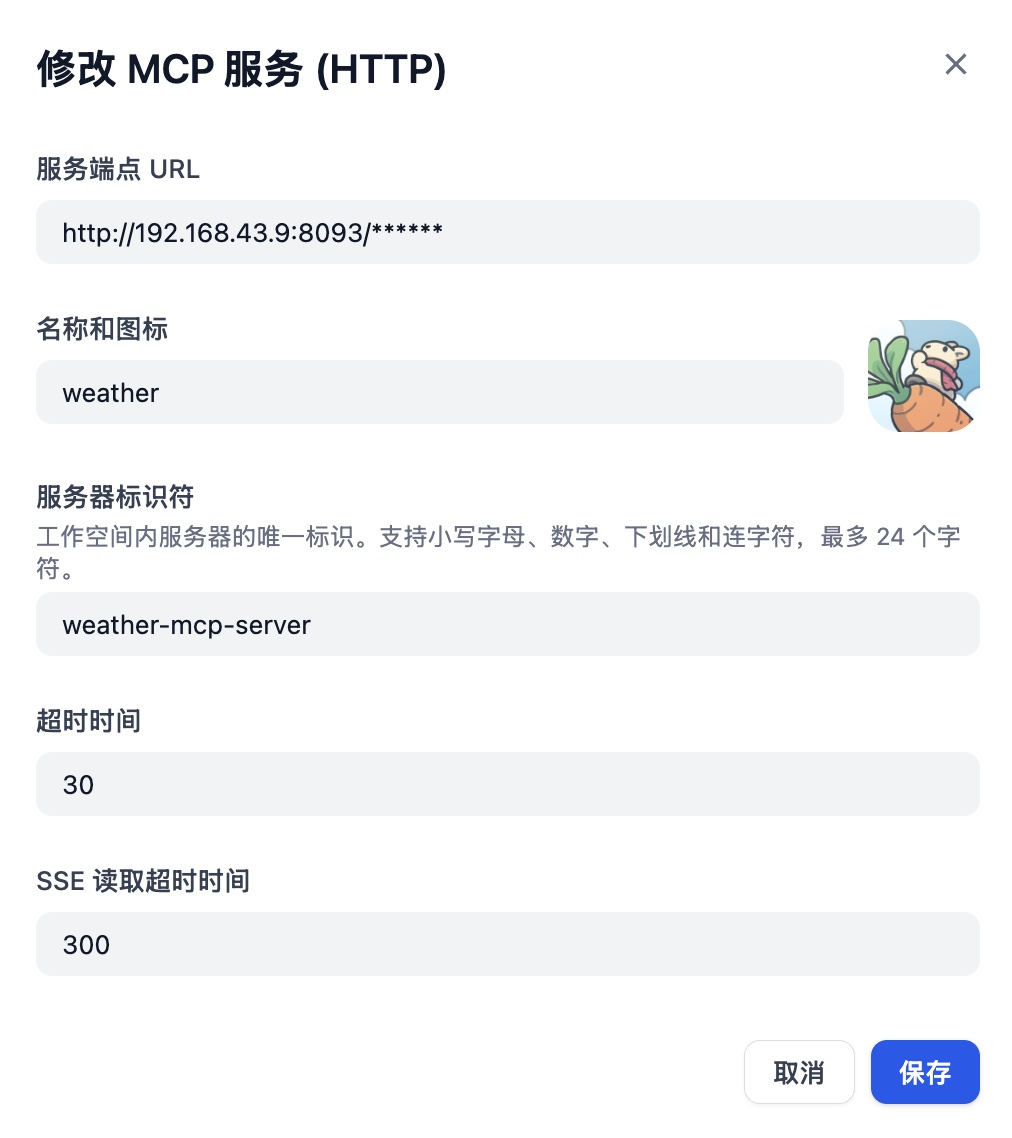
工具 → MCP → 添加 MCP 服务 (HTTP),按下表填写:
| 字段 | 填写内容 | 说明 |
|---|---|---|
| 服务端点 URL | http://192.168.43.9:8093/sse |
必须带 /sse 后缀,IP 换成自己的 |
| 名称和图标 | weather |
与 FastMCP("weather") 保持一致便于识别 |
| 服务器标识符 | weather-mcp-server |
工作空间内唯一,仅支持小写字母、数字、下划线和连字符,最多 24 字符 |
| 超时时间 | 30 |
单次请求超时(秒) |
| SSE 读取超时时间 | 300 |
长连接读取超时(秒),工具耗时较久时调大 |
保存后 Dify 会去握手并拉取工具列表。状态显示 已授权、且列出 包含 2 个工具(get_alerts / get_forecast)即接入成功。这里的工具描述正是 Python 函数的 docstring —— docstring 就是给大模型看的工具说明书,写得越清楚模型选工具越准。
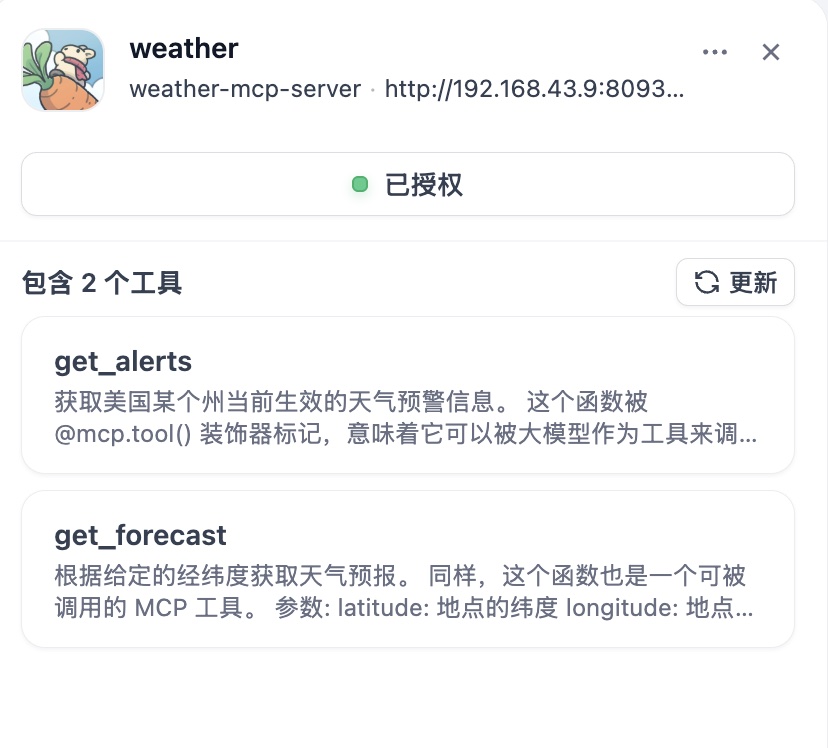
服务端重启或新增工具后,点右上角 更新 重新拉取工具列表。
8.3 用法一:Agent 应用绑定工具(模型自主编排)
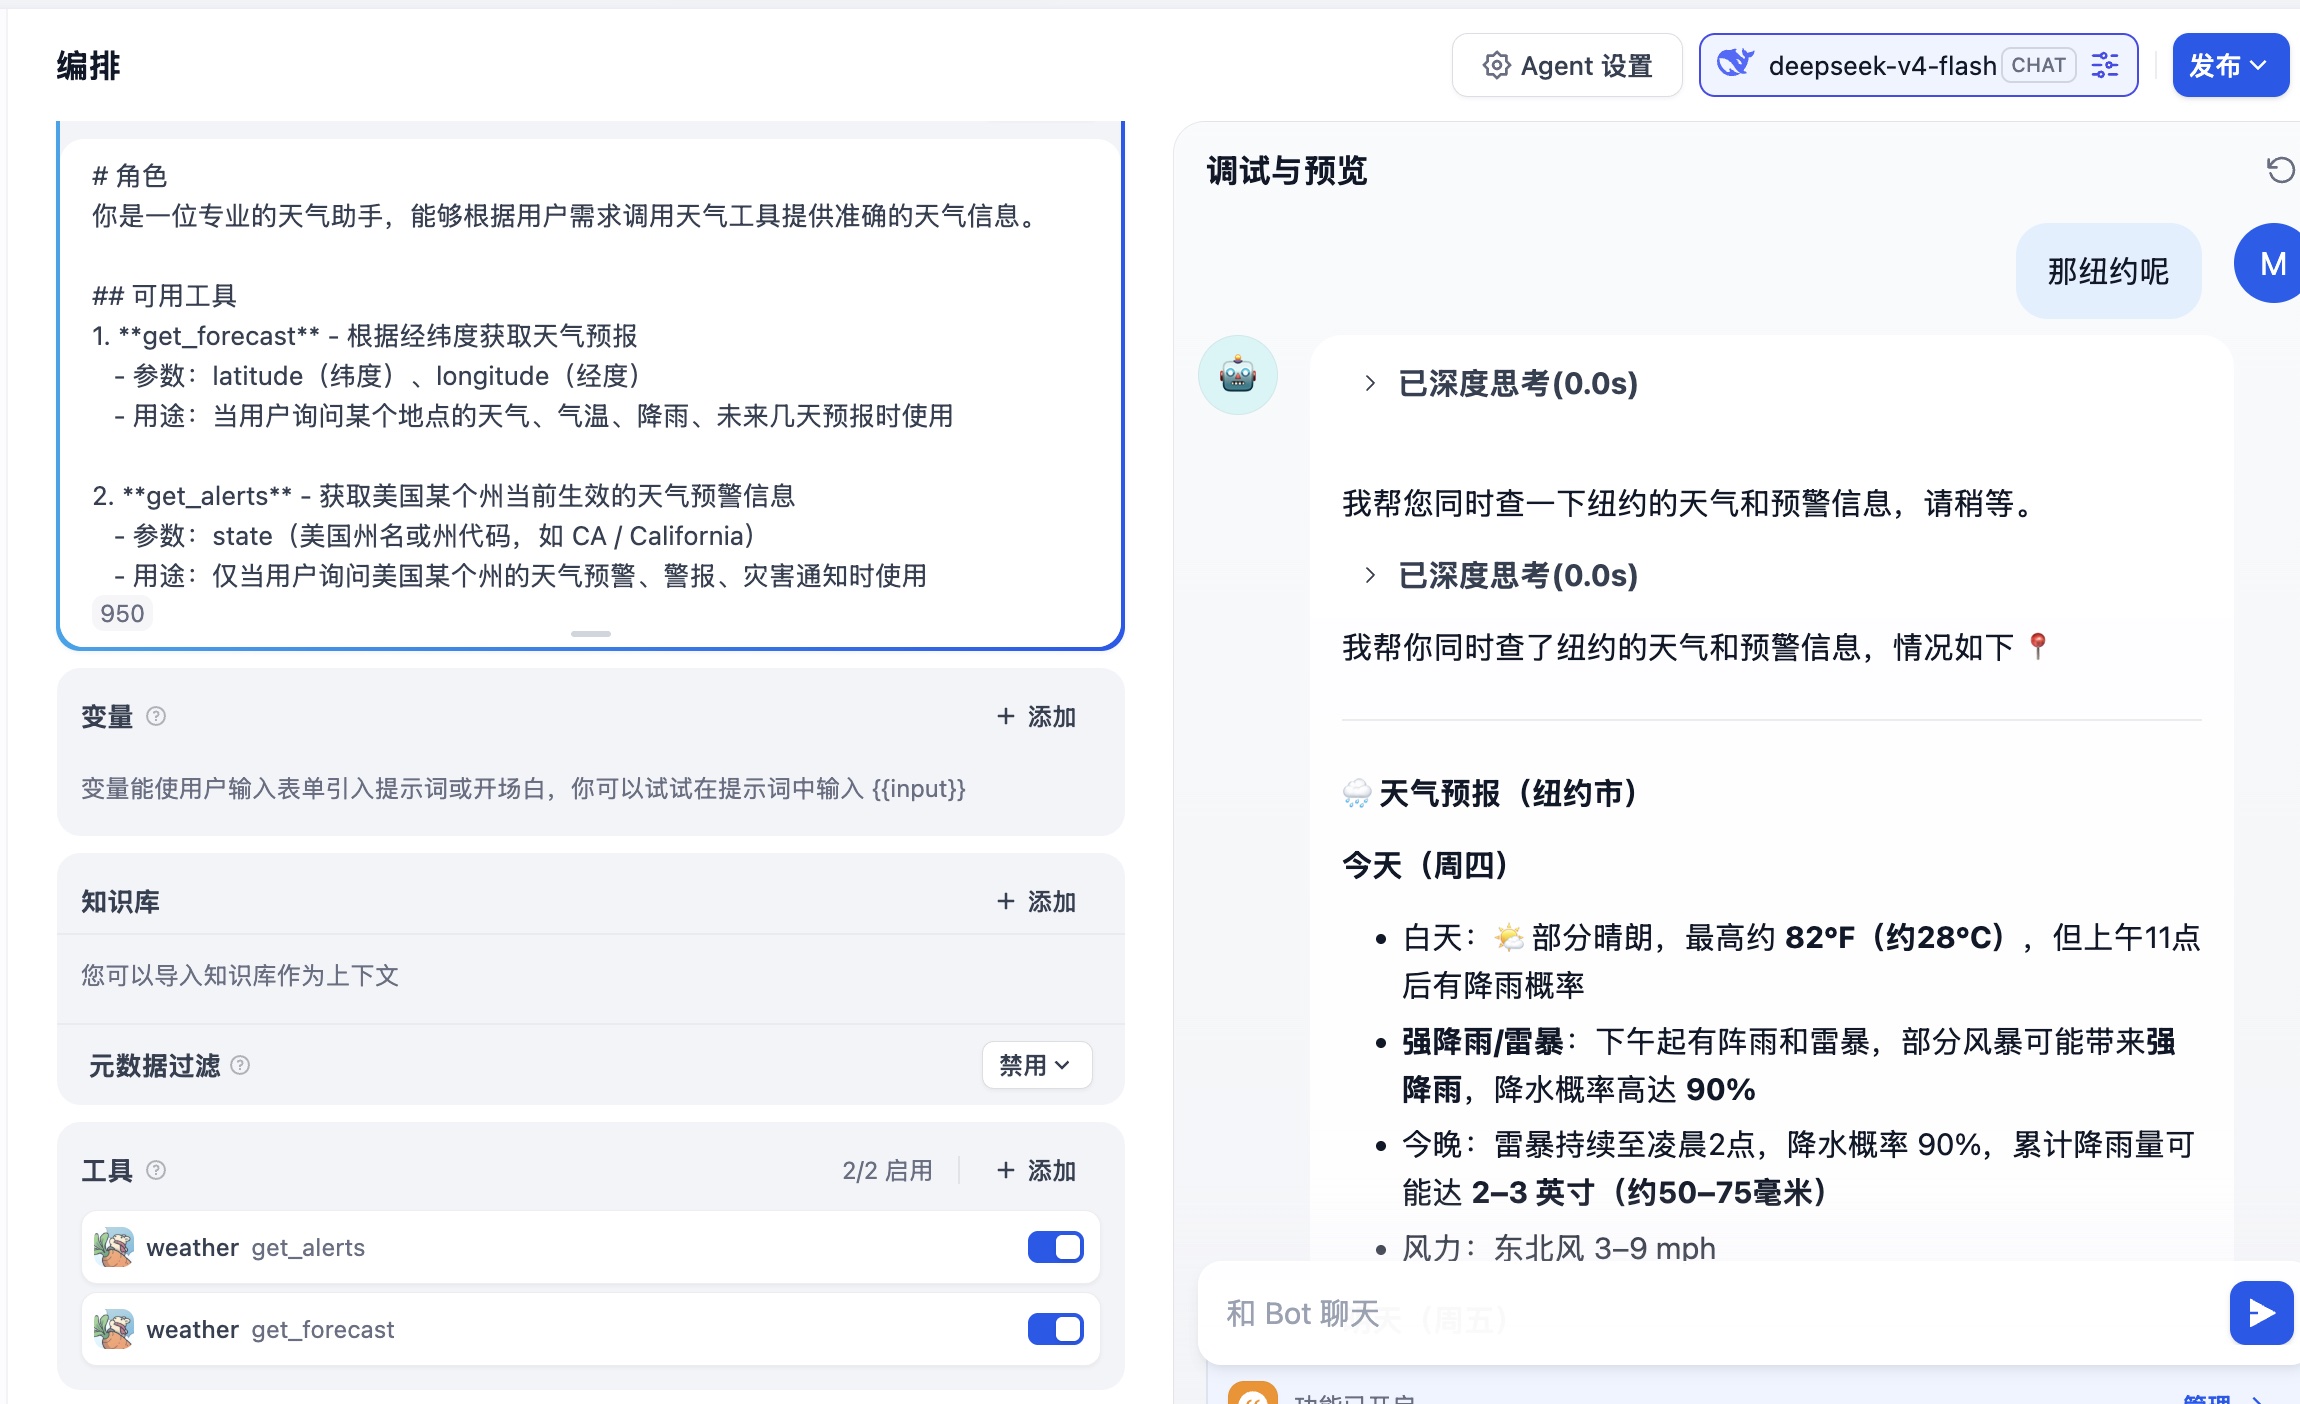
新建 Agent 应用 → 在 工具 区域 + 添加 刚才的 weather 工具(get_alerts、get_forecast 各自独立开关)→ 选择支持 function-calling 的模型(图中为 deepseek-v4-flash)。
提示词里显式说明每个工具的参数与适用场景,能显著降低模型选错工具、漏传参数的概率:
# 角色
你是一位专业的天气助手,能够根据用户需求调用天气工具提供准确的天气信息。

## 可用工具
1. **get_forecast** - 根据经纬度获取天气预报
   - 参数:latitude(纬度)、longitude(经度)
   - 用途:当用户询问某个地点的天气、气温、降雨、未来几天预报时使用

2. **get_alerts** - 获取美国某个州当前生效的天气预警信息
   - 参数:state(美国州名或州代码,如 CA / California)
   - 用途:仅当用户询问美国某个州的天气预警、警报、灾害通知时使用
调试预览里提问”那纽约呢”,模型会自行把地名转成经纬度、并行调用两个工具,再汇总成结构化回答:
8.4 用法二:Chatflow 工作流中作为节点调用(流程固定)
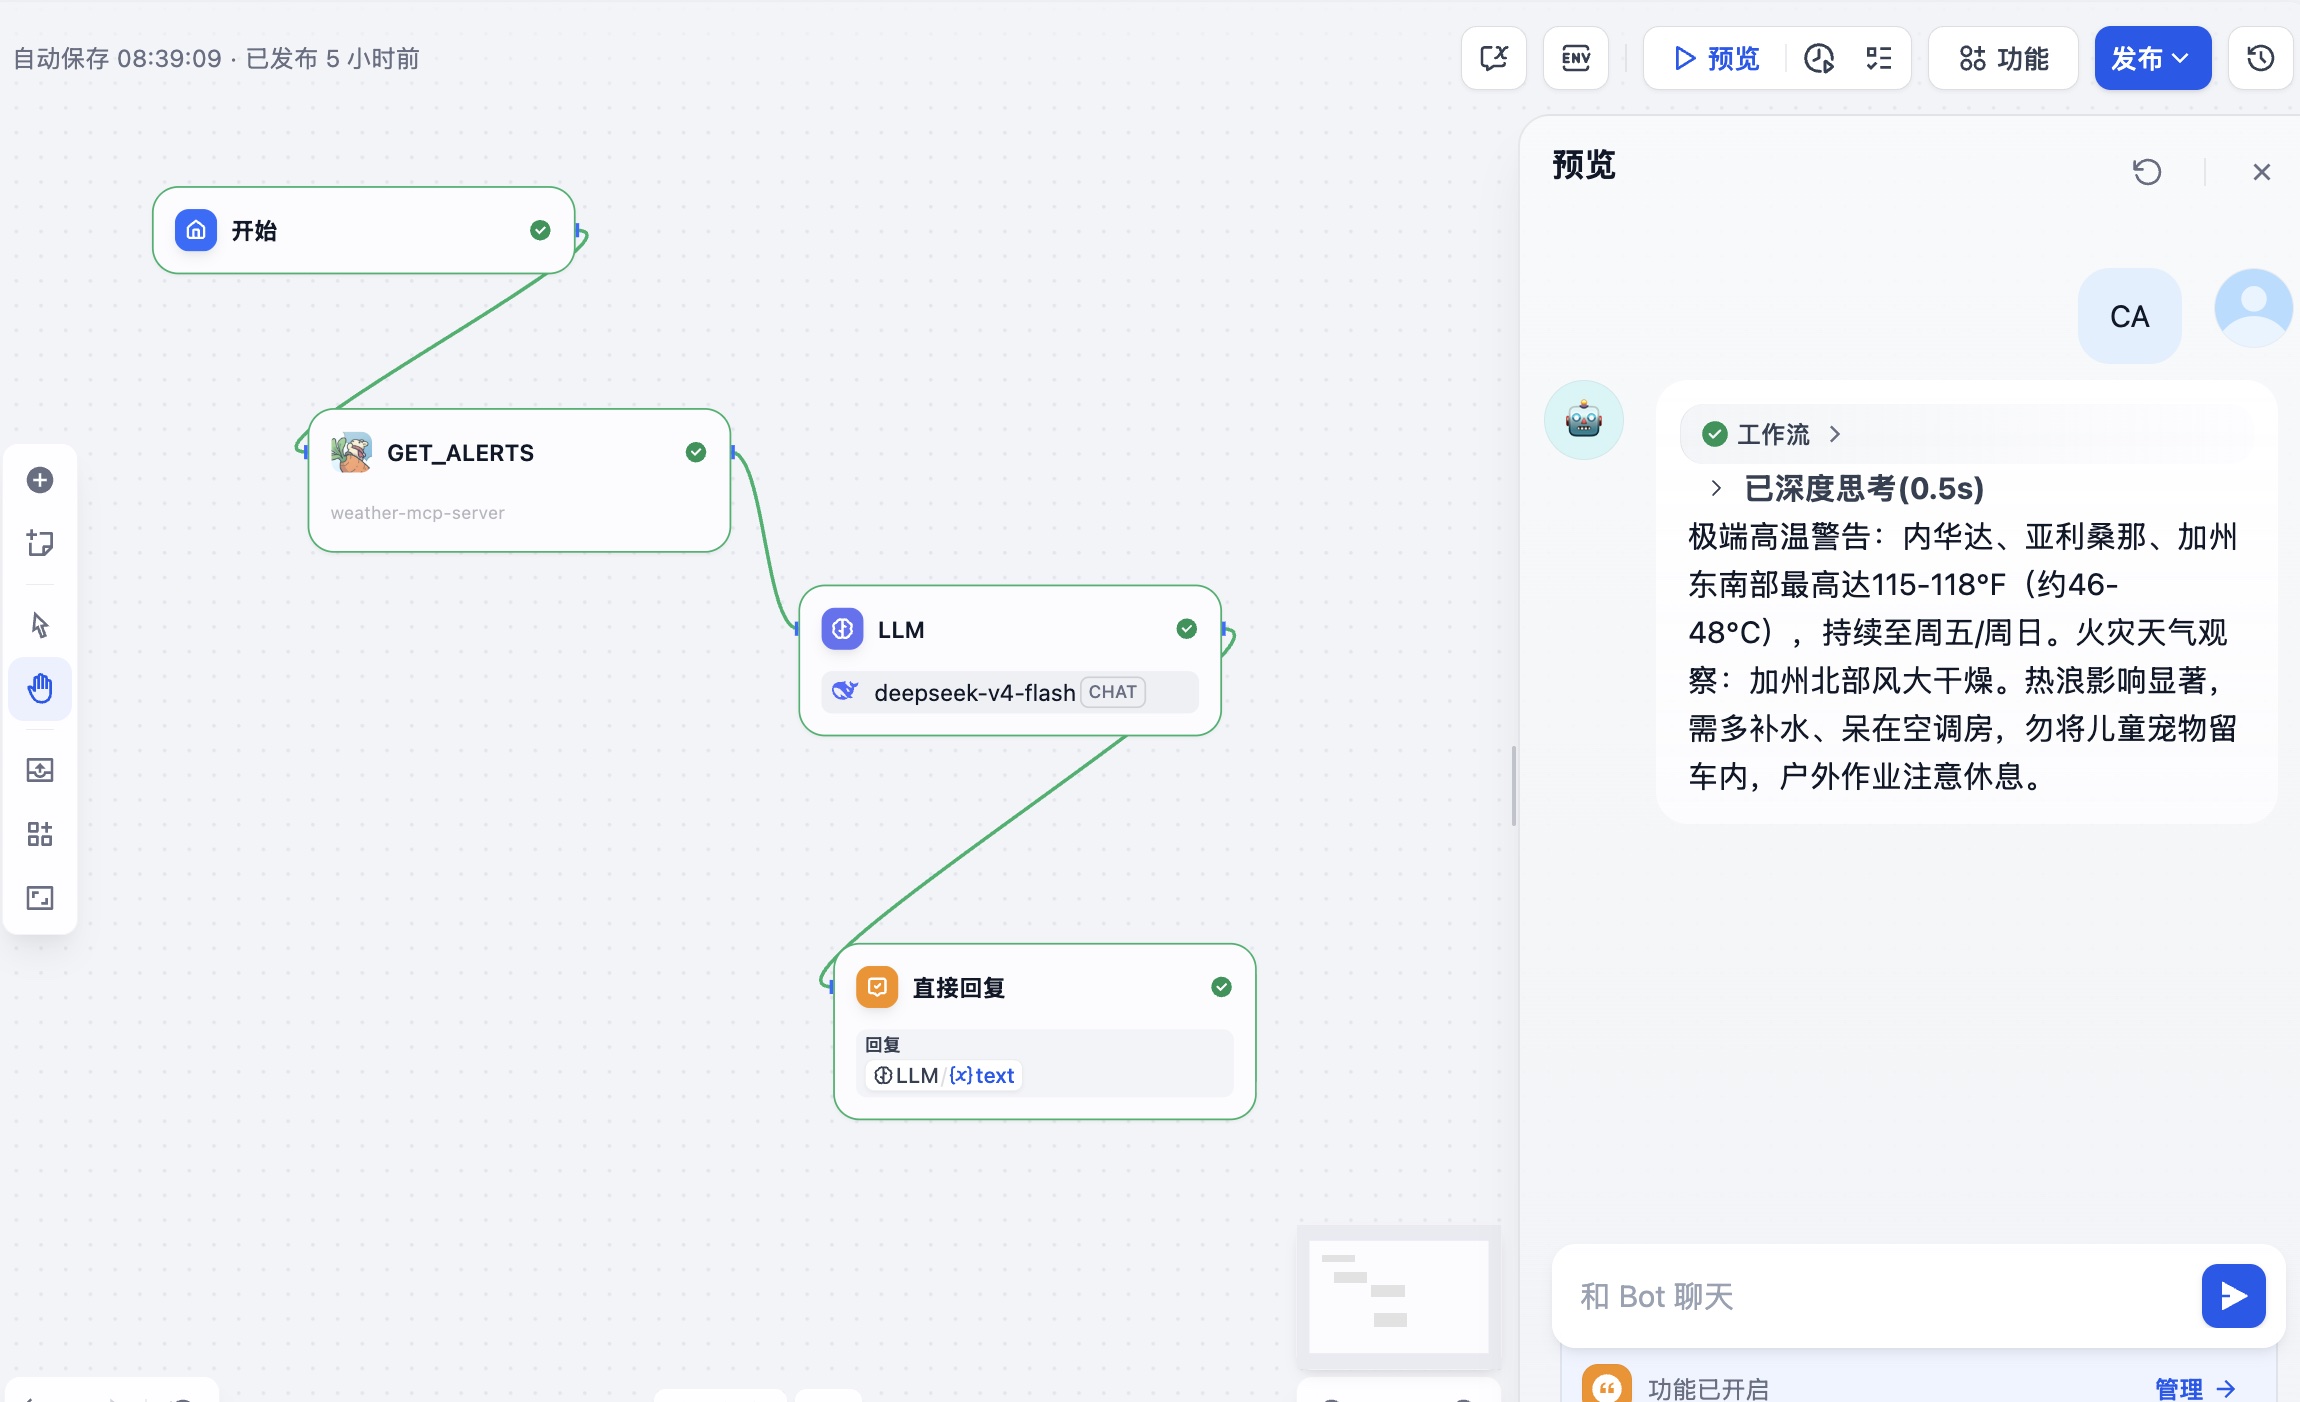
MCP 工具在 Chatflow / Workflow 里会作为普通工具节点出现,可直接编排到流程中:
开始 → GET_ALERTS (weather-mcp-server) → LLM (deepseek-v4-flash) → 直接回复
GET_ALERTS 节点接收 开始 节点的用户输入(如 CA)作为 state 参数,把原始预警文本交给 LLM 节点做归纳润色,最后由 直接回复 节点输出 LLM/text。
8.5 两种用法怎么选
| 维度 | Agent 绑定工具 |
Chatflow 节点编排 |
|---|---|---|
| 调用时机 | 模型按需自主决策 | 流程写死,必定执行 |
| 参数来源 | 模型从对话中推断 | 显式绑定上游节点变量 |
| 适用场景 | 开放式问答、多工具组合 | 流程确定、要求稳定可控 |
| 可控性 / 可调试性 | 依赖提示词质量 | 每个节点输入输出可见 |
8.6 常见问题
| 现象 | 排查方向 |
|---|---|
| 保存时提示连接失败 | 漏了 /sse 后缀;或服务端仍绑在 127.0.0.1(未加 host="0.0.0.0") |
| Docker 部署的 Dify 连不上 | 端点填了 localhost,应换成宿主机局域网 IP 或 host.docker.internal |
| 工具列表为空 | 服务端未用 @mcp.tool() 装饰;或改完代码没重启、没点”更新” |
| 调用超时 | 调大「SSE 读取超时时间」;get_forecast 需三次外网请求,本身较慢 |
| 模型不调工具 / 传错参 | 完善函数 docstring,并在提示词里补充工具用途与参数说明 |
九、环境变量
| 变量 | 用途 |
|---|---|
OPENAI_API_KEY |
chat_bot.py 驱动 gpt-4o 决策 / 调工具 |
DEEPSEEK_API_KEY |
第七节 VSCode Cline、第八节 Dify 配置使用的模型 |
无需任何 API key 即可单独启动 papers.py 或 weather/weather.py——服务端本身只依赖 arxiv 与 httpx;调用工具时各客户端自带模型即可。
十、学习路径建议
- 协议入门:第一 ~ 三节 → 配合
weather/weather.py(先 stdio、再切 sse 接入 IDE) - 本地服务端:
papers.py(同时演示 Tools + Prompts + 落盘资源) - 客户端集成:
chat_bot.py(stdio + OpenAI function-calling + 对话循环) - 真实 IDE 体验:第七节,跟着
Cline配置走一遍(stdio) - 接入低代码平台:第八节,
Dify注册远程MCP服务(sse),体会Agent自主编排与Chatflow固定流程两种范式