MySQL实践-索引和日志
索引和日志的使用
普通索引和唯一索引区别是什么?
对于查询来说,普通索引和唯一索引查询性能差距微乎其微,在按条件找到k=5的记录时,普通索引会多做一次”查找和判断”的操作,直到下一条记录不为5。
但对于更新操作,性能差别是比较大的,当要更新的目标页不在内存中时,唯一索引会将数据从磁盘读入内存(涉及随机IO的访问,成本最高的操作之一)。
- 唯一索引,需要将数据页读入内存,判断到没有冲突,插入这个值,语句执行结束;
- 普通索引,则是将更新记录在
change buffer,语句执行结束;
在mysql执行更新操作时,若数据页刚好在内存中,则直接更新。否则,InnoDB会将更新操作缓存在change buffer中,在下一次查询将数据页加载到内存后,
会将change buffer应用到原数据页,此过程称之为merge。除了访问数据页merge外,系统有后台线程定期merge(如数据库正常关闭)。
change buffer和redo log的理解,执行insert into t(id, k) values(id1, k1), (id2, k2);
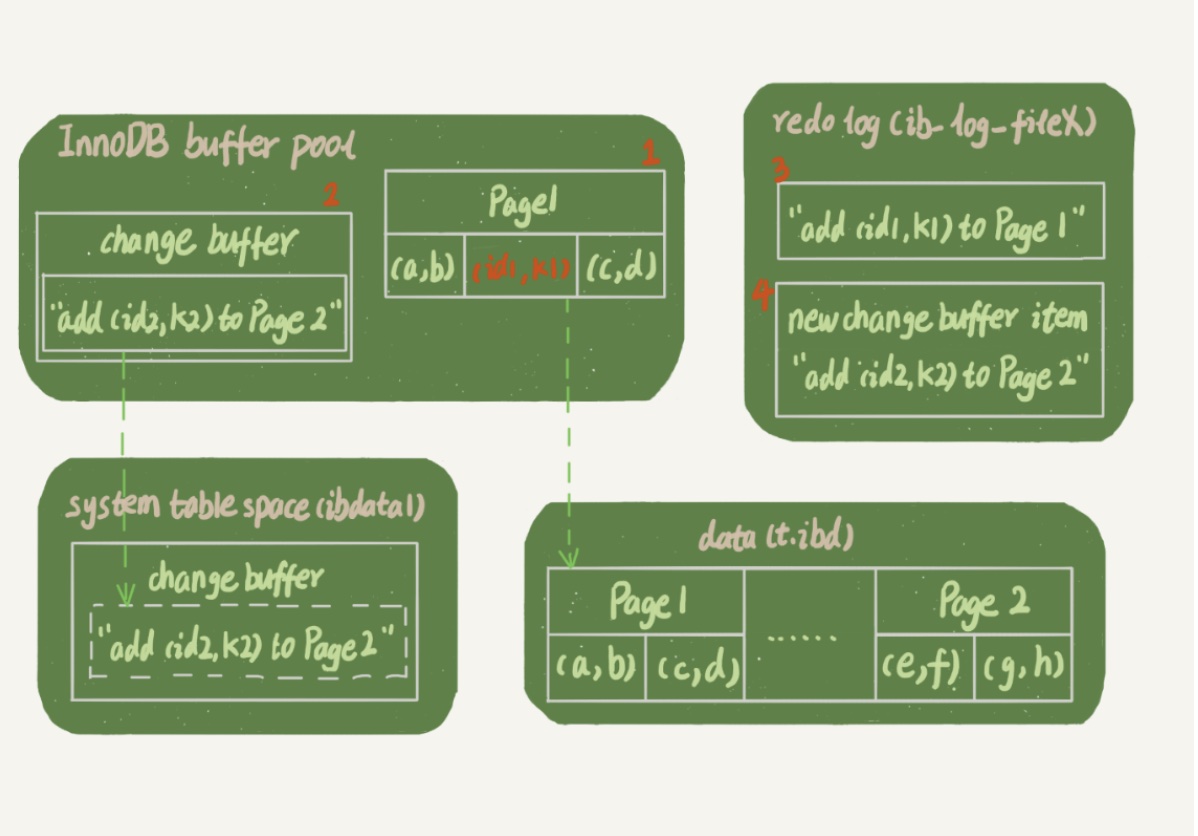
分析这条更新语句,它涉及了四个部分:内存、redo log(ib_log_fileX)、数据空间(t.idb)、系统表空间(ibdata1)。
1、Page 1在内存中,直接更新内存;
2、Page 2没有在内存中,就在内存的change buffer区域,记录下”我要往Page 2插入一行”这个信息;
3、将上述两个动作记入redo log中(图中3和4);
mysql索引选择
选择索引是mysql优化器的工作,扫描行数、是否适应临时表、是否排序等因素,都会影响索引的选择,可以使用force index(xx)来强制mysql走指定的索引。
一个索引上不同的值越多,这个索引的区分度就越好,而一个索引上不同值个个数,我们就称之为”基数”(cardinality),也就是说,这个基数越大,索引的区分度越好。
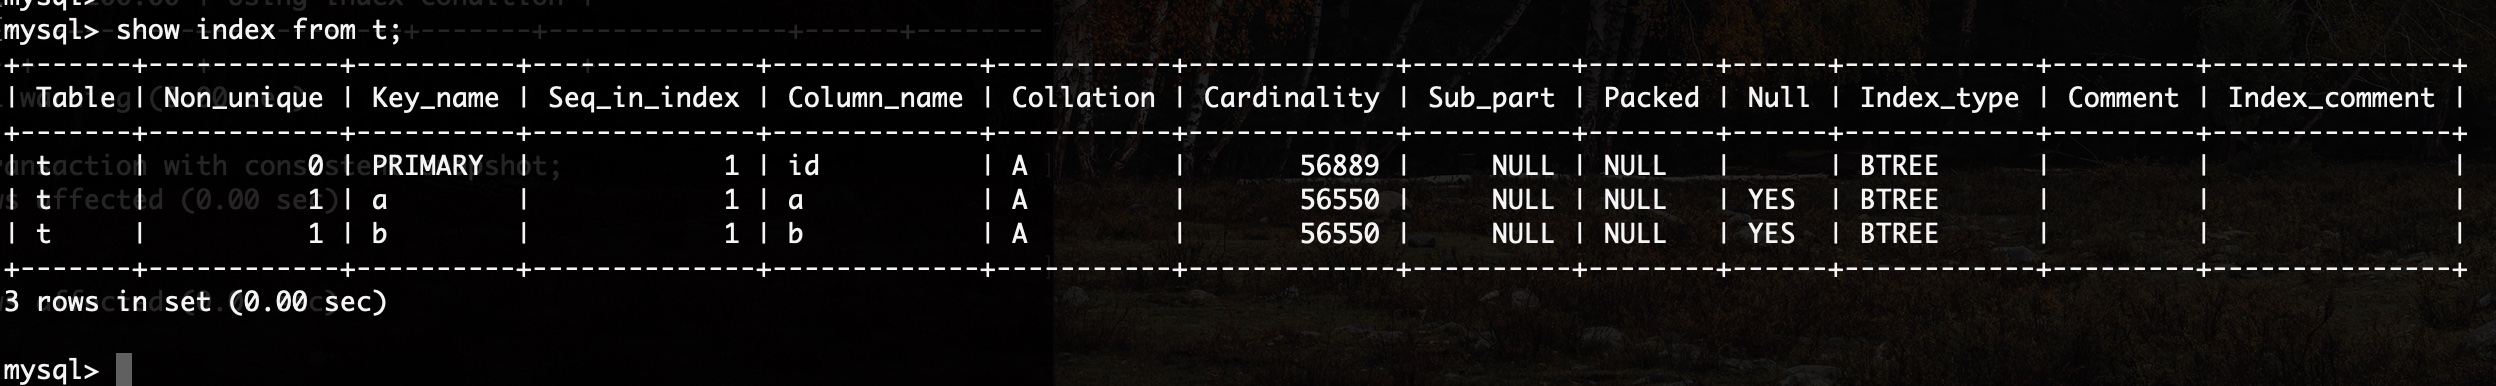
对长字符串加索引,可以将整个字段做为索引,也可以选字符串前n位做为前缀索引(mysql支持)。具体选择多少位,需要看字段前n位做distinct。
使用前缀索引,优点:就可以做到既节省空间,又不用额外增加太多的查询成本,不足: 用不上覆盖索引对查询性能的优化。
对于长文本字段(例如,身份证),如何利用上索引?
- 第一种,倒序存储,
sql实际查询时id_card = reverse(input_id_card_string); - 第二种,使用hash字段,在表上额外再创建一个字段,存储
crc32计算后的hash值,同时对这个字段添加索引;
mysql突然执行慢了,有可能是因为在flush刷新脏页?刷新脏页可能是如下4种情况:
redo log写满了,这时候系统会停止所有的更新操作,把checkpoint往前推进,redo log留出空间可以继续写。- 内存不足,当需要新的内存页时,就要淘汰一些数据页,空出内存给别的数据页使用。
mysql认为系统空闲的时候,见缝插针地找时间,刷新脏页;mysql正常关闭的时,mysql会把内存的脏页都flush到磁盘上,这样下次mysql启动的时候,可以直接从磁盘上读数据,启动速度会很快。
表空间和count sql慢
mysql中表数据清了一半,但文件大小没变?
InnoDB的数据是按页存储的,表中删除一行时,InnoDB会把这一行标记为删除。而如果我们是删掉一个数据页上的所有记录,则整个数据页就可以被复用了。
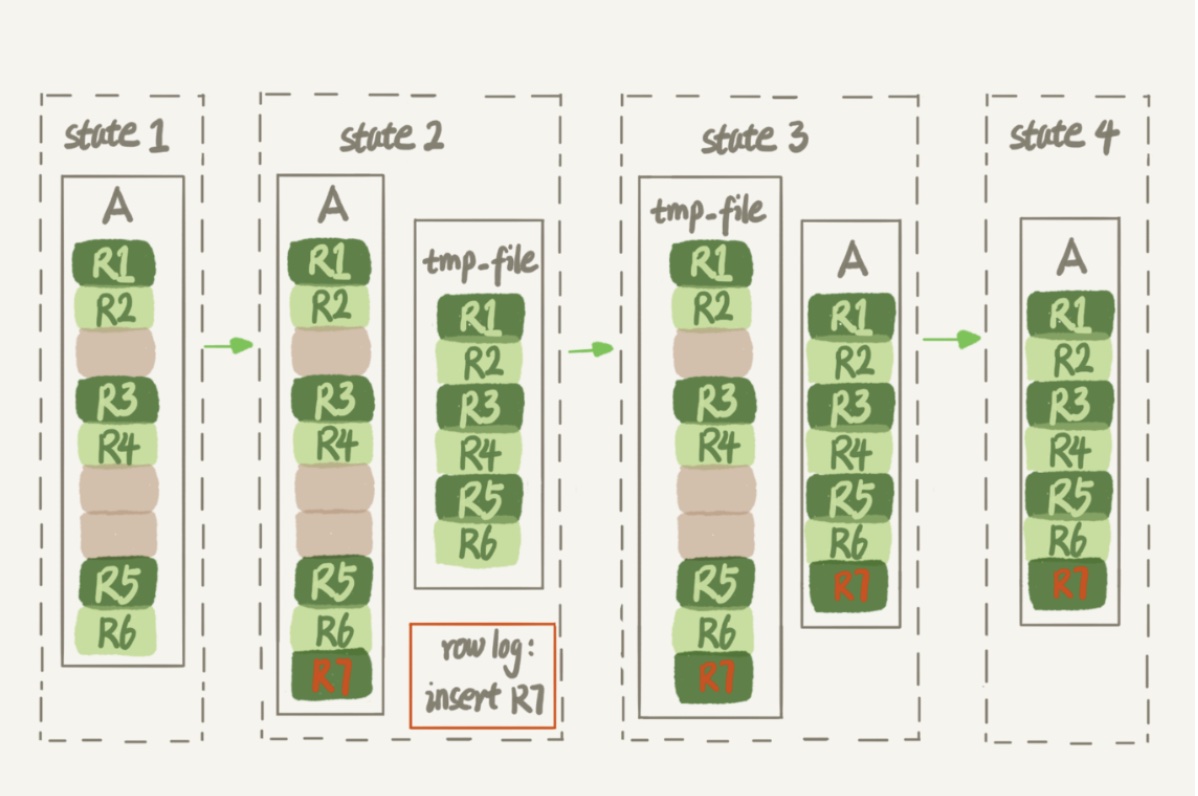
/* 重建表(移除空记录): 创建一个临时表,然后将表A上的数据 按照id顺序依次写入临时表,最后将数据重命名 */
alter table A engine=InnoDB;
在MySQL 5.6之后引入了Online DDL,简单来说:在生成新表时,允许在线增、删、改数据,在线操作会放在row log中,生成临时文件后,会将日志文件
的操作应用于临时文件。
mysql count(*)的实现
MyISAM引擎将表的总行数存在了磁盘上,执行count(*)时就会返回这个数,效率很高。而InnoDB引擎,由于MVCC逻辑,在执行count(*)时,
需要把数据一行一行从引擎中读出来。