MySQL 基础篇
mysql环境准备
启动一个mysql容器,对外端口号是3316,root用户默认的登陆密码是root:
docker run -p 3316:3306 --name mysql5.7 -v /Users/madong/opt/mysql5_7/conf:/etc/mysql/conf.d -v /Users/madong/opt/mysql5_7/logs:/logs -v /Users/madong/opt/mysql5_7/data:/var/lib/mysql -e MYSQL_ROOT_PASSWORD=root -d mysql:5.7
# 进入到mysql容器中,查看当前的mysql的连接信息
docker exec -it mysql5.7 /bin/bash
# 查看数据库的连接情况,当前的mysql实例有一个连接对象:
mysql> show processlist;
#+----+------+-----------+------+---------+------+----------+------------------+
#| Id | User | Host      | db   | Command | Time | State    | Info             |
#+----+------+-----------+------+---------+------+----------+------------------+
#|  2 | root | localhost | NULL | Query   |    0 | starting | show processlist |
#+----+------+-----------+------+---------+------+----------+------------------+
#1 row in set (0.00 sec)
mysql组件概览
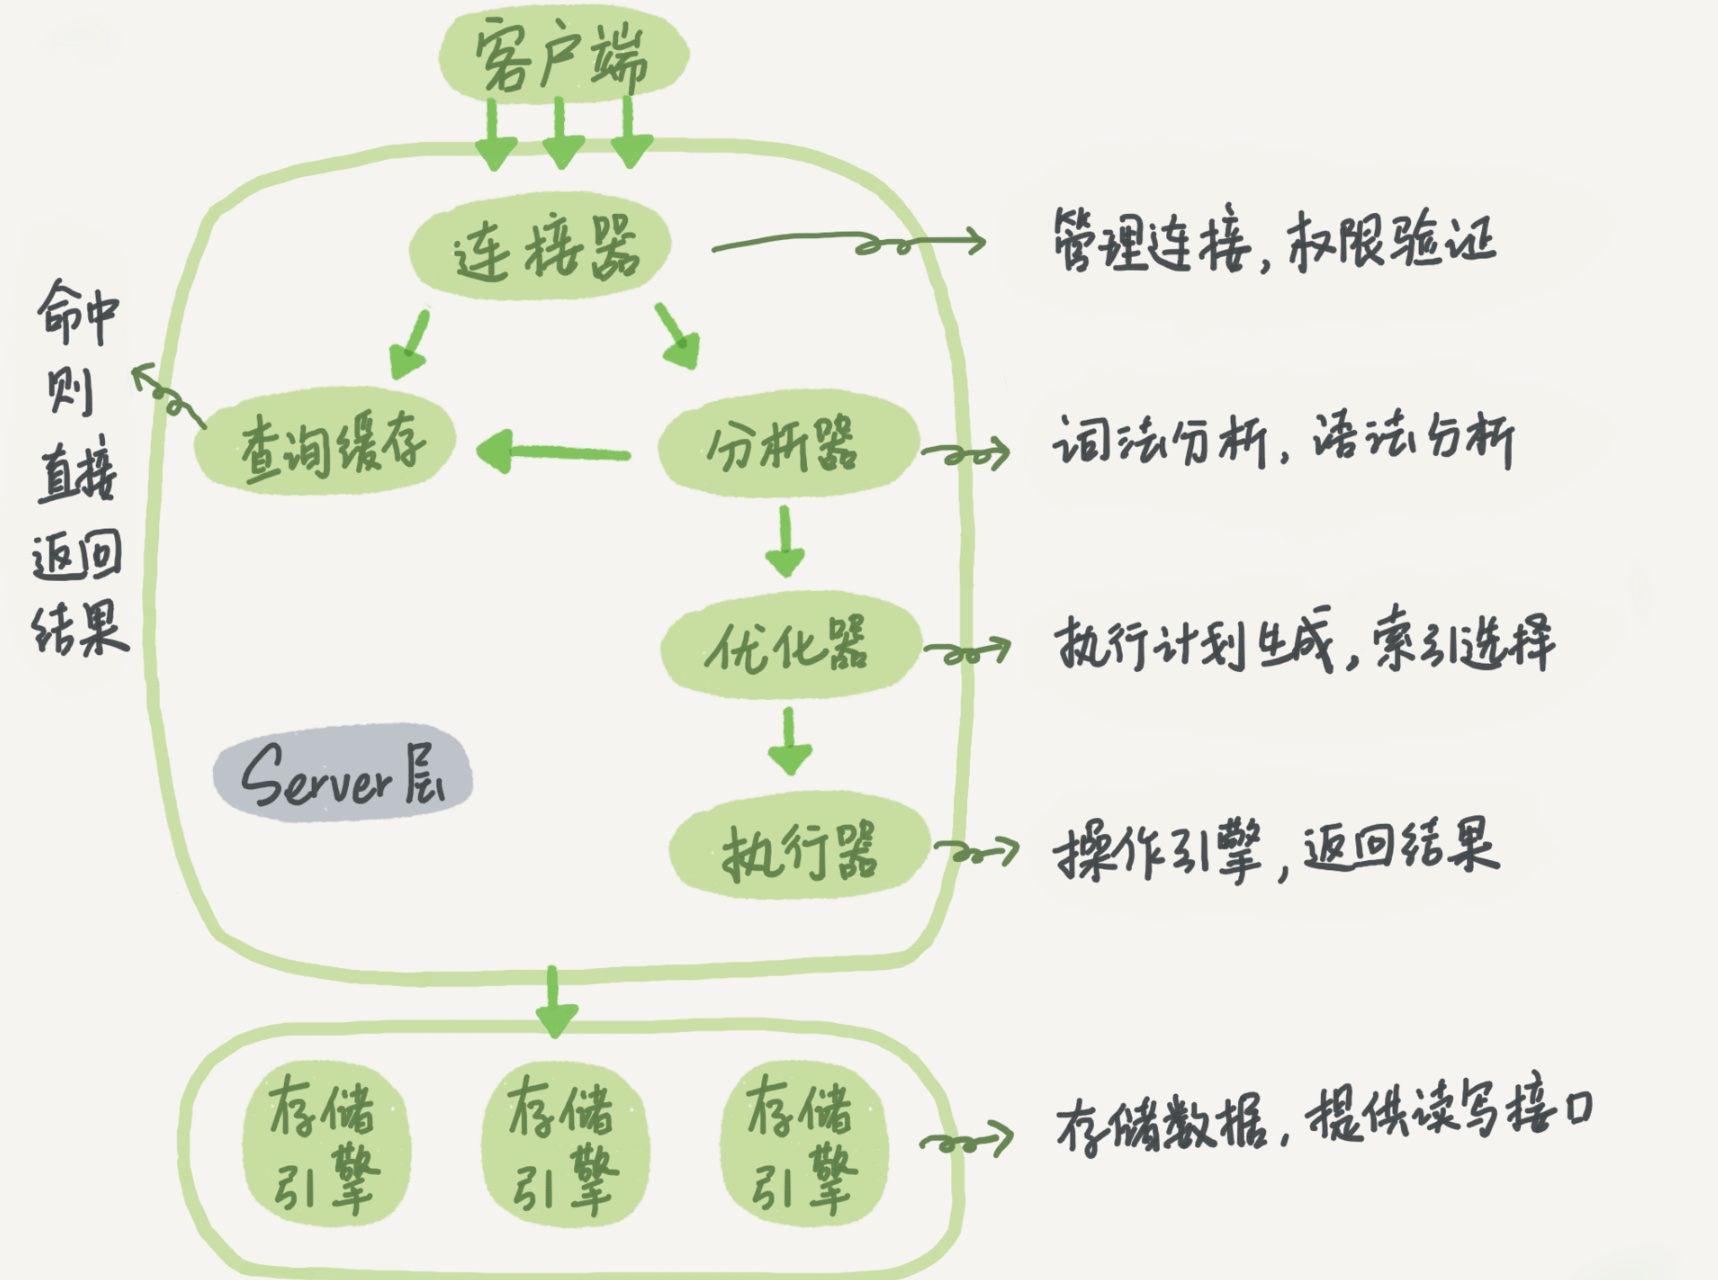
大体来说,MySQL可以分为Server层和存储引擎两部分。其中,Server层包括连接器、查询缓存、分析器、优化器、执行器等,涵盖MySQL的大多数核心服务功能。而存储引擎层负责数据的存储和提取,现常用的存储引擎是InnoDB。
- 连接器:连接器负责根客户端建立连接、获取权限、维持和管理连接,连接命令一般为:
mysql -h$ip -P$port -u$user -p - 查询缓存:连接建立后,就可以执行
select语句,若缓存中有此语句的查询缓存,则直接返回结果。不建议开启,MySQL 8.0已移除此部分; - 分析器:包含词法分析、语法分析,执行的
sql是否符合语法规范,另外,查询的表或字段是否存在? - 优化器: 当表中有多个索引时,优化器决定使用哪个索引,决定各表的连接顺序;
- 执行器:在执行器阶段,开始执行语句。会判断你对这个表
T有没有执行查询的权限,若没有,就返回没有权限的错误;
mysql中的日志模块,redo log、binlog以及两阶段提交?拿更新语句分析,在专栏中,作者拿”孔乙己”中记账粉板来类比,MySQL中的WAL也就是先写日志,然后再写磁盘。
mysql> update T set c=c+1 where ID=2;
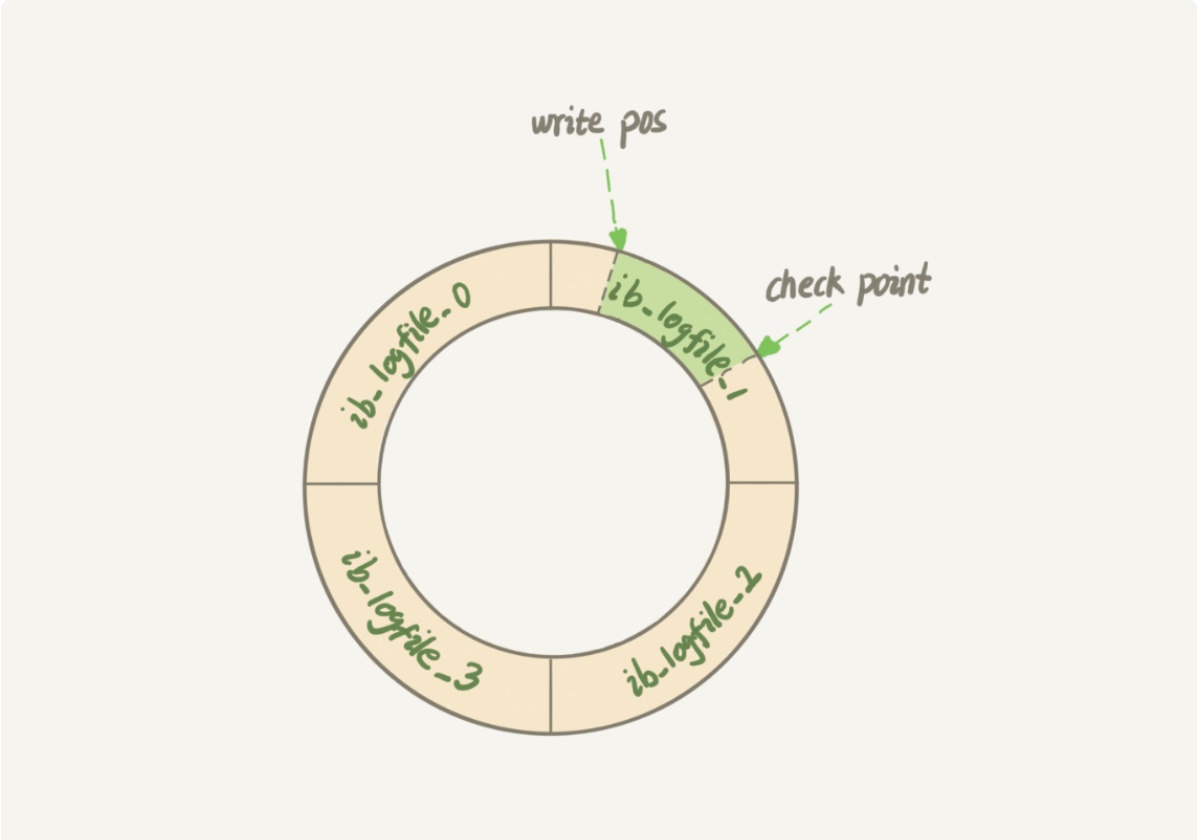
当有一条记录更新时,InnoDB引擎就会先把记录写到redo log(粉板)里面,并更新内存,这个时候更新就算完成了。InnoDB的redo log是固定大小的,可以配置一组4个文件,每个文件的大小是1GB。
在下图中,write pos是当前记录的位置,checkpoint是当前要擦除的位置,当write pos追上checkpoint时,表示”粉板”满了,这时候不能再执行新的更新。
在server层也有自己的日志,称为binlog(归档日志),经常问的redo log和bin log的区别有哪些?
- 1、
redo log是InnoDB引擎特有的,binlog是MySQL的Server层实现的,所有引擎多可以使用。 - 2、
redo log是物理日志,记录的是”在某个数据页上做了什么修改”;binlog是逻辑日志,记录这个语句的原始逻辑,比如”给ID=2这一行c字段加1“。 - 3、
redo log是循环写,空间固定会用完。binlog是追加写入的,当binlog文件写到一定大小后会切换下一个,并不会覆盖以前的日志。
mysql的两阶段提交,是为了让redo log和binlog保持一致。具体步骤为,mysql中有这一行先写入redolog中,处于prepare阶段,然后写binlog,写完后提交事务,处于commit状态。
扩展,binlog和redolog的写入机制:
binlog写入,事务执行过程中,会先把日志写到binlog cache,事务提交的时候,再把binlog cache写入binlog文件中。
每个线程都有自己的binlog cache,但是他们共用一份binlog文件。
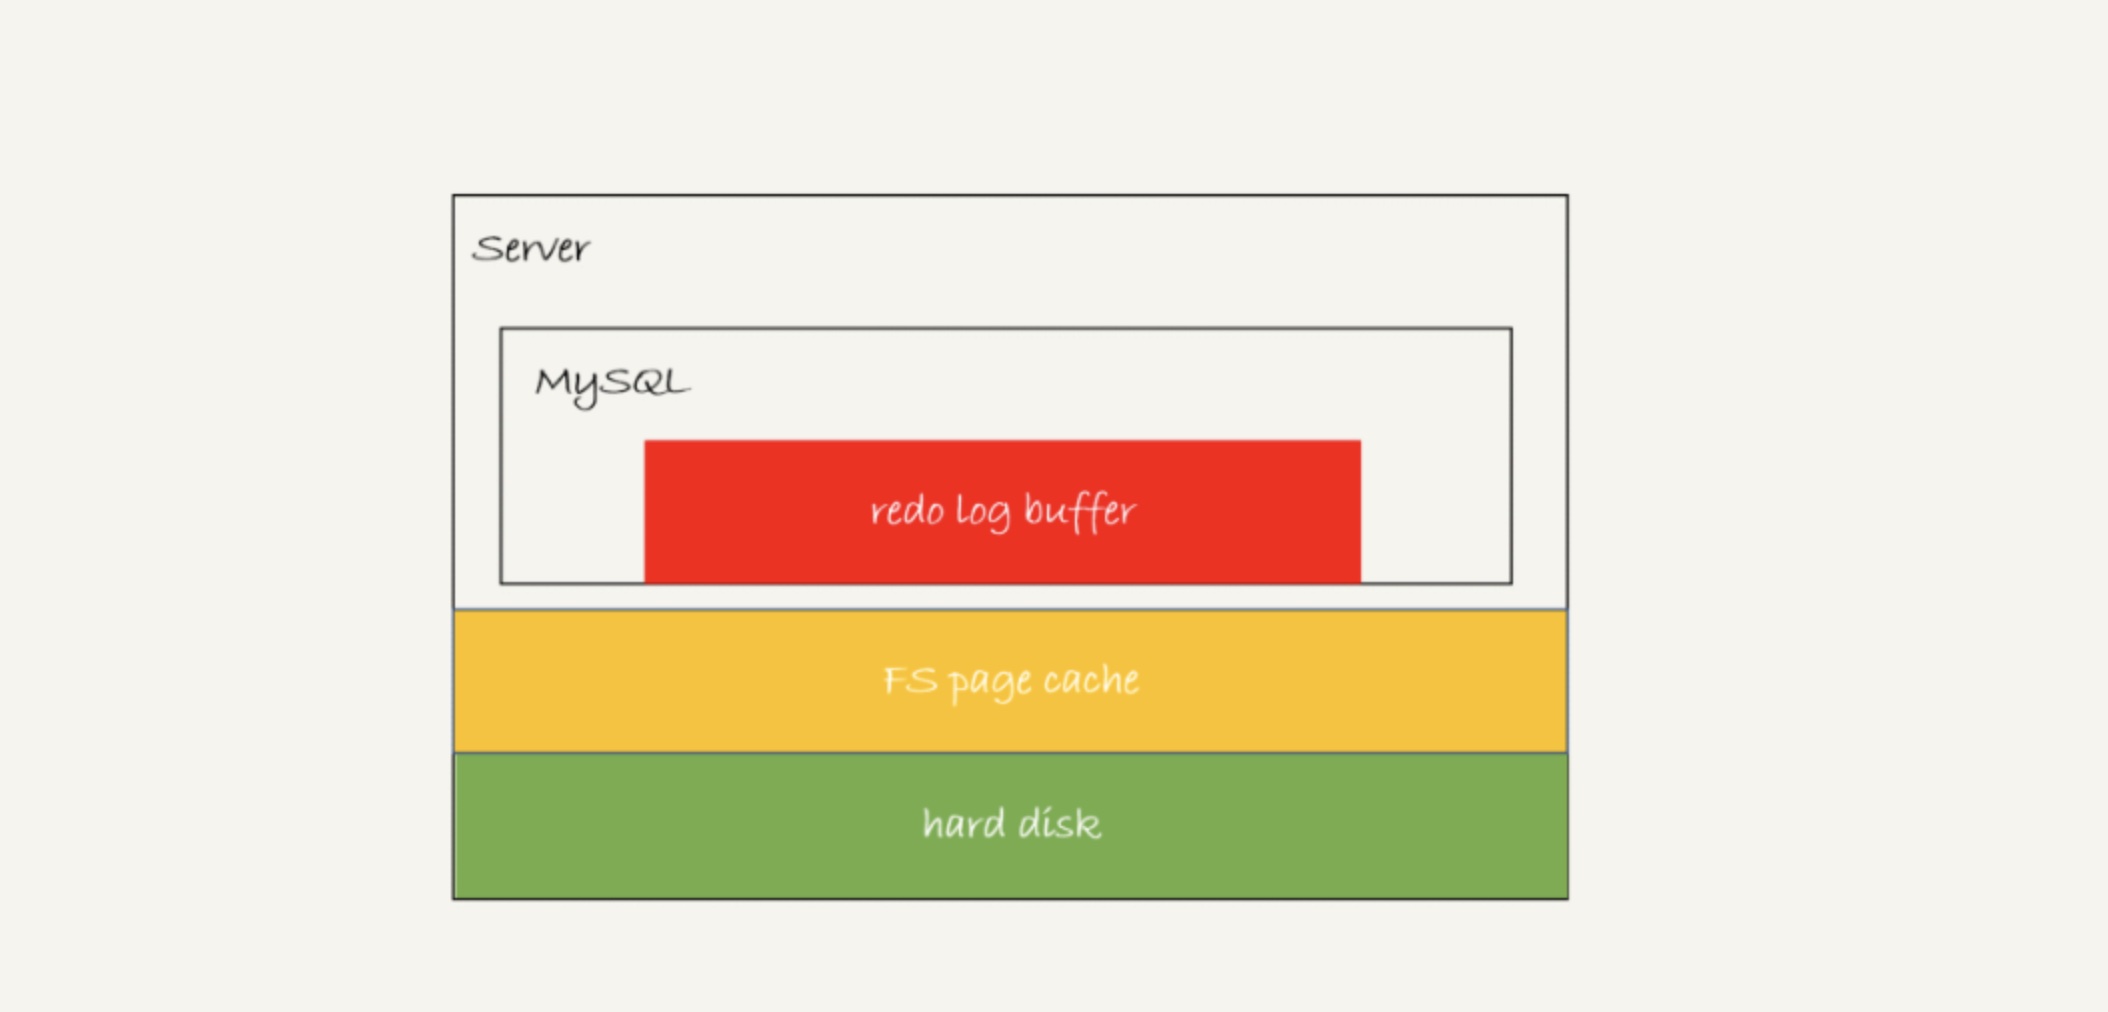
redo log也是先写redo log buffer,然后写到page cache里面(上图黄色部分),然后持久化到磁盘上。InnoDB对innodb_flush_log_at_trx_commit提供了3种取值:
0,每次提交只把redo log留在redo log buffer中;1,每次提交都将redo log持久化到磁盘;2,每次提交都把redo log写到page cache中;
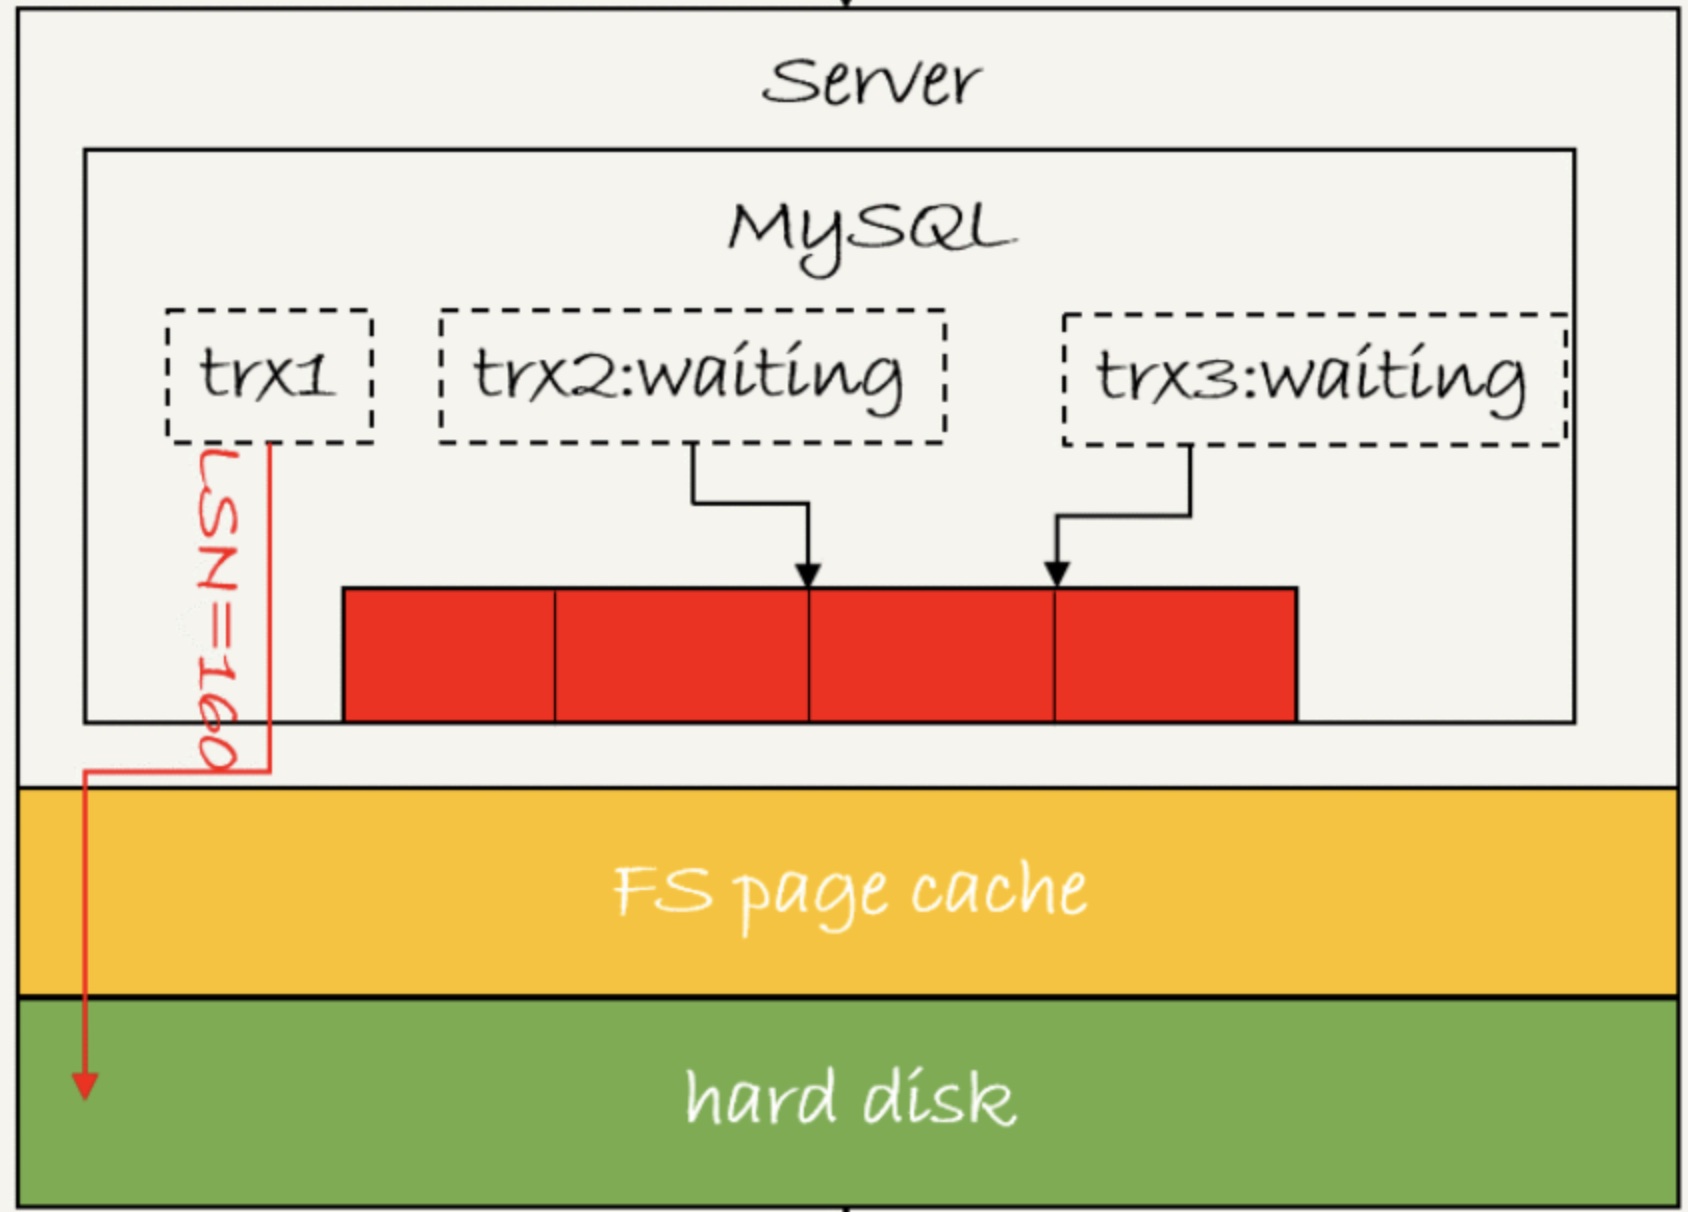
mysql日志的组提交机制,LSN是单调递增的,用来对应redo log的一个个写入点。如下图,是三个并发事务(trx1, trx2, trx3)在prepare阶段,都写完redo log buffer,持久化到磁盘的过程,对应的LSN分别是50、120和160。
trx1是第一个到达的,会被选为这组的leader,像写redo log和binlog都会以组为单位,因而,一次组提交里面,组员越多,节约磁盘IOPS的效果越好。
若MySQL遇到了性能瓶颈,并且是在IO上,则可以考虑调参:
- 设置
binlog_group_commit_sync_delay和binlog_group_commit_sync_no_delay_count参数,减少binlog的写盘次数。 - 将
sync_binlog设置为大于1的值(比较常见是100~1000)。这样做的风险是,主机掉电时会丢binlog日志。 - 将
innodb_flush_log_at_trx_commit设置为2(写page cache,避免丢redo log)。这样做的风险是,主机掉电的时候会丢数据。
mysql的事务
提到事务,肯定会想到ACID(Atomitity、Consistency、Isolation、Durability),即原子性、一致性、隔离性、持久性。MySQL事务的隔离级别分为:读未提交、
读已提交、可重复读和串行化。
在”可重复读”级别下,视图是在事务启动时创建,整个事务存在期间都用这个视图。在”读提交”隔离级别下,这个视图是在每个SQL语句开始执行的时候创建。”读未提交”隔离
级别直接返回记录的最新值,没有视图的概念;而”串行化”隔离级别下直接用加锁的方式来避免并行访问。
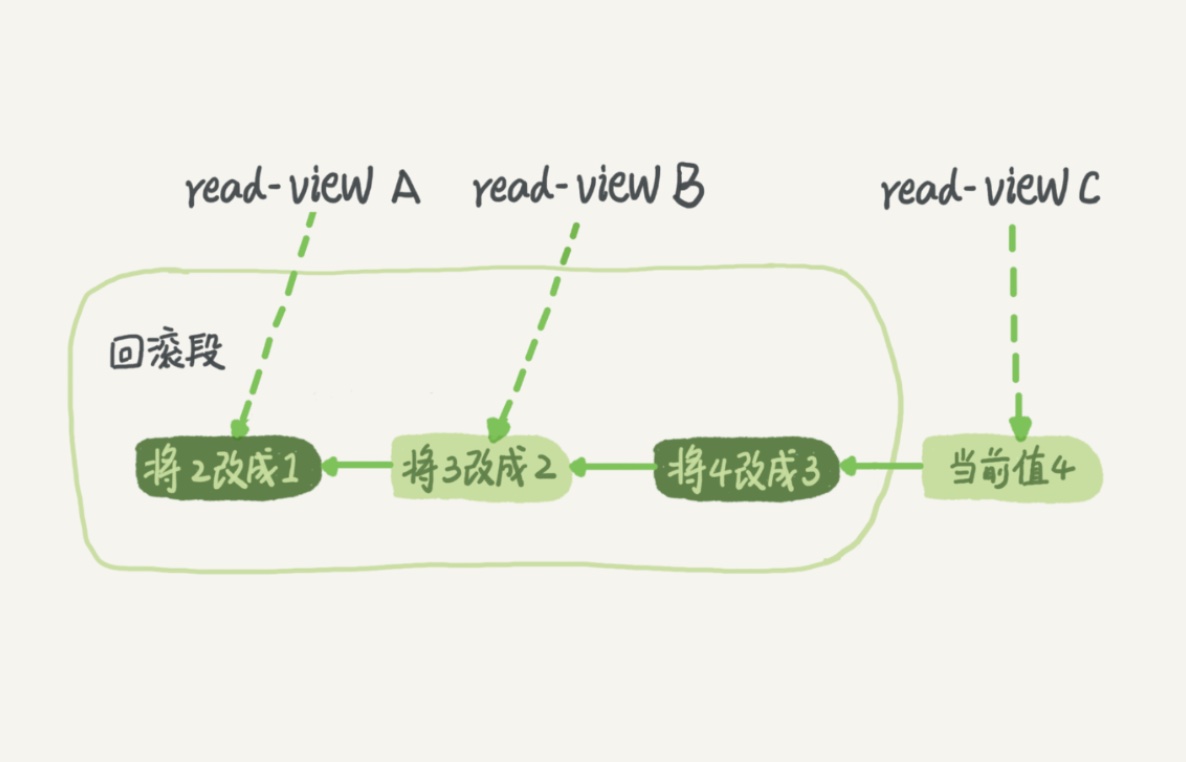
在mysql中,每条记录在更新时都会同时记录一条回滚操作,记录上的最新值,通过回滚操作,都可以得到钱一个状态的值。一个值从1被按顺序改成了2、3、4,在回滚日志里面会有类似下面的记录。
在视图A、B、C里面,同一条记录在系统中可以存在多个版本,就是数据库的多版本并发控制(MVCC)。回滚日志,在不需要的时候才删除,也就是说,当没有事务
再需要用到这些回滚日志时,回滚日志会被删除。
事务到底是隔离的还是不隔离的?
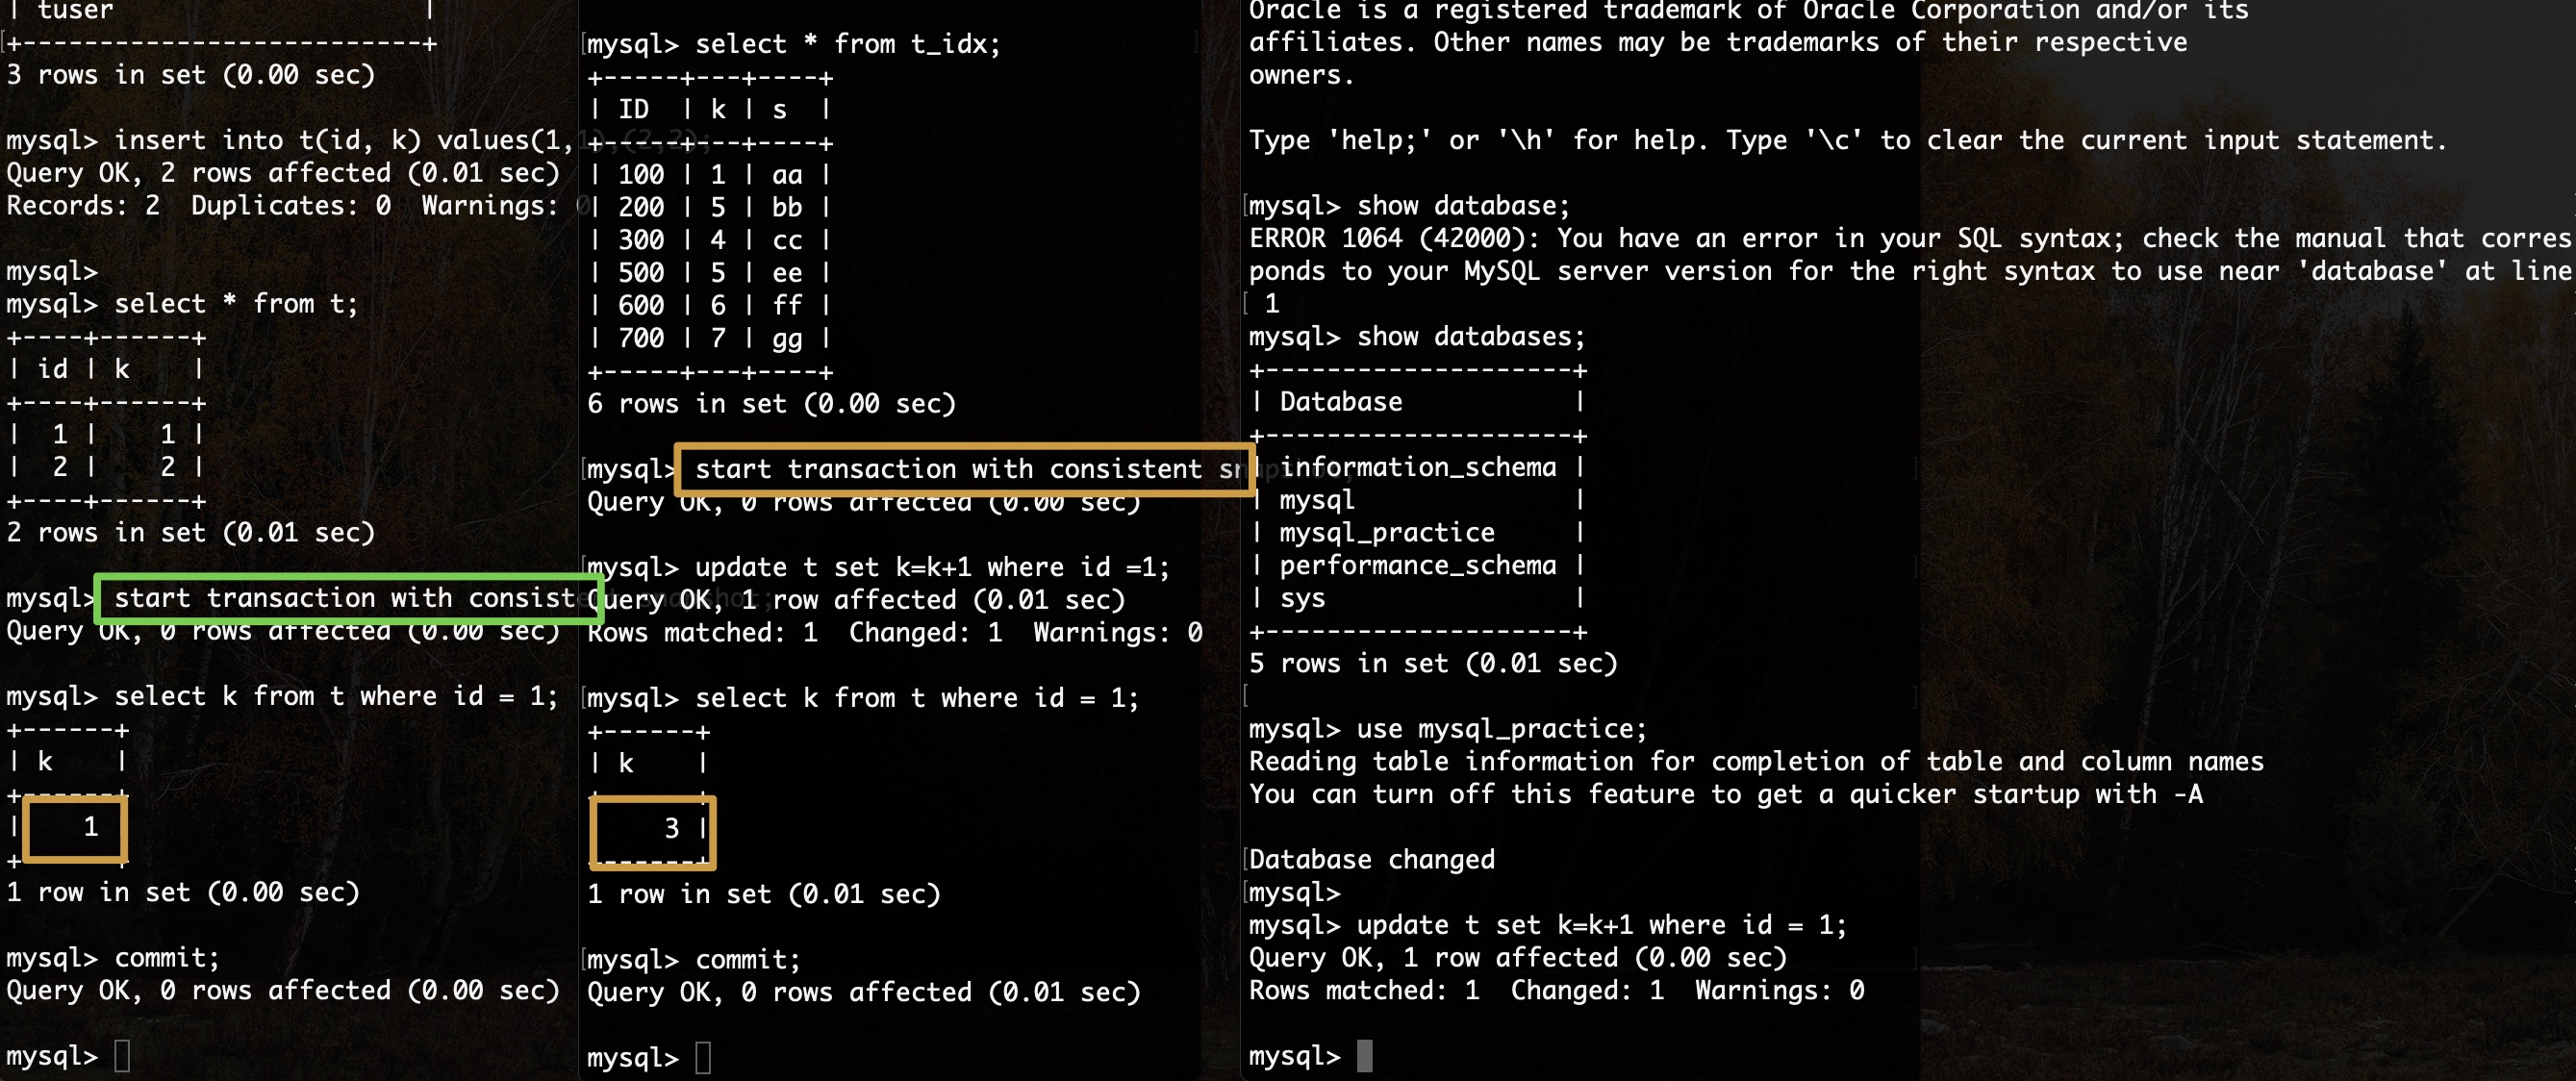
如下启动3终端中执行操作,事务A和事务B查询的值是多少呢?若想要马上启动一个事务,可以使用start transaction with consistent snapshot这个命令。
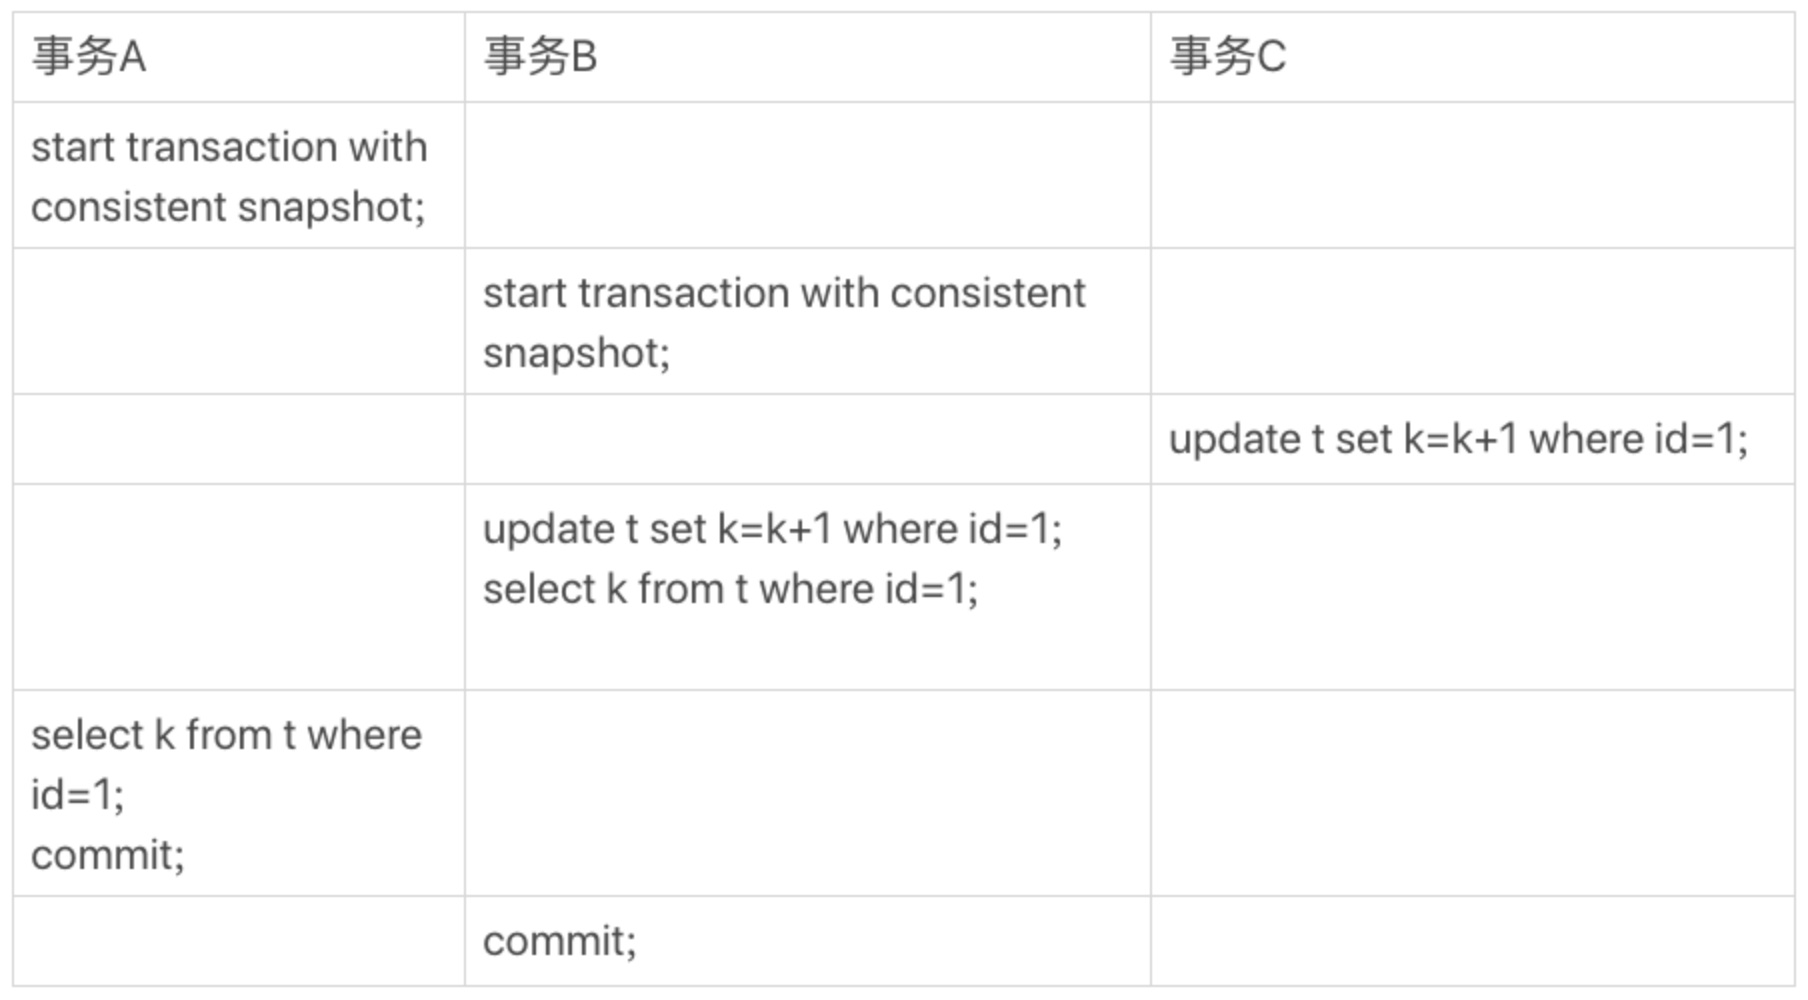
实际执行下来,事务A看到k的值为1,事务B看到k的值为3。分析原因?
- 第一个有效更新是事务
C,将数据从(1,1)改成了(1,2),这个时候新版本的row tx_id是102,90是历史版本。 - 第二个有效更新是事务
B,将数据从(1,2)改成了(1,3),这时数据的最新版是101,而102又成为了历史版本。 - 事务
A查询时,其实事务B还没有提交,事务B生成的版本对事务A必须不可见,否则就变成脏读了。
快照在MVCC里面是如何工作的?
InnoDB中每个事务都有一个唯一的事务ID,叫做transaction id。它是在事务开始的时候向InnoDB申请的,是按申请顺序严格递增的。
每行数据也都是有多个版本,每次更新事务数据时,都会生成一个新的数据版本,并把transaction_id赋值给这个数据版本的事务ID,记为row trx_id。
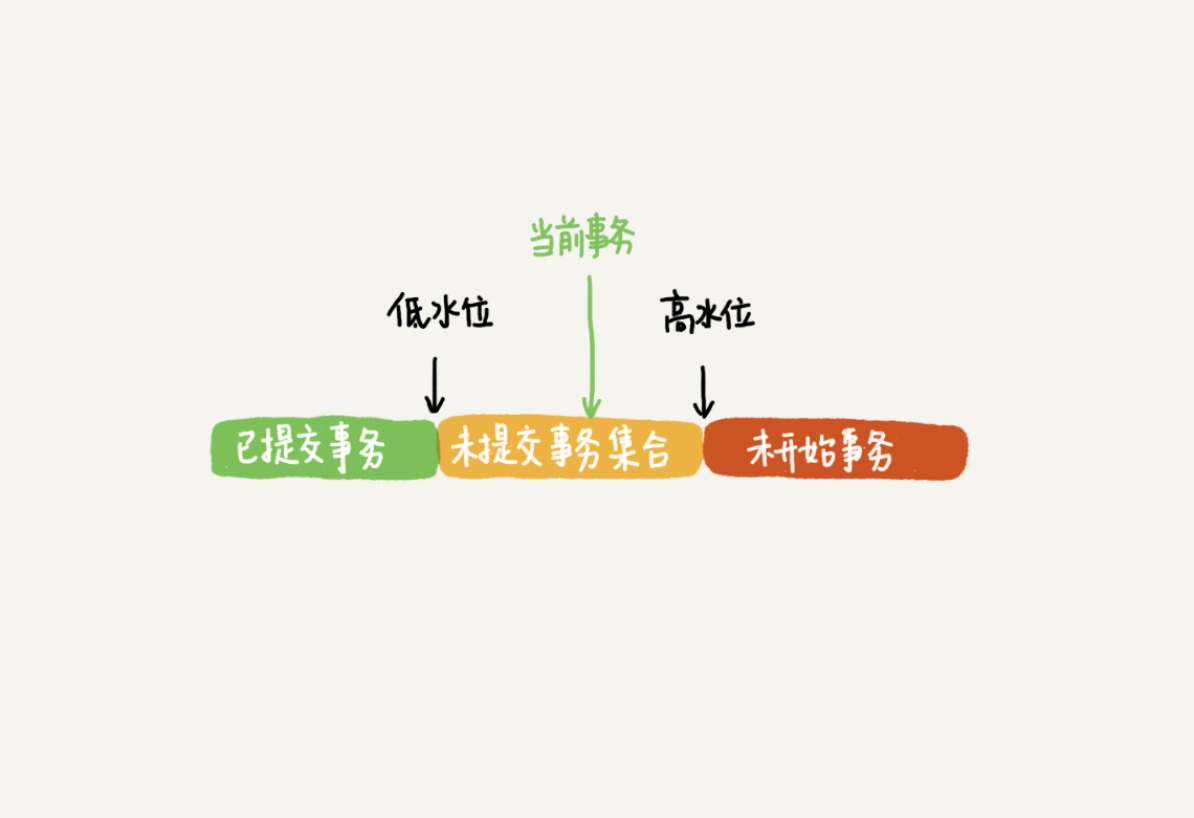
如下图,一个数据版本的row trx_id,有以下几种可能:
- 落在绿色部分,表示这个版本是已提交的事务或是当前事务自己生成的,是可见的;
- 落在红色部分,表示这个版本是由将来启动的事务生成的,是不可见的;
- 落在黄色部分,若
row trx_id在数组中,表示这个版本是由还没提交的事务生成的,不可见;若row trx_id不在数组中,表示这个版本是已提交了的事务生成的,可见。
更新数据规则: 更新数据都是先读后写的,而这个读,只能读当前的值,称为”当前读”(current read),除了update语句外,select语句加锁,也是当前读。
# lock in share mode和for update都是当前读
select k from t where id = 1 lock in share mode;
select k from t where id = 1 for update;