HugeGraph 生产踩坑录:10 个真实部署中的适配问题
客户环境 1 亿+ 实体点、百亿级数据、HBase 存储背景下的 10 个 bug 与 workaround 接前两篇 ES 主题,本文把视角切到国产开源图数据库 HugeGraph。本文整理 10 个来自生产一线的实战问题(含向社区提的 5 个 issue),每个按”现象 → 排查 → 解决方案”三段式展开——适合 HugeGraph 部署 / 调优工程师、ETL 数据接入开发、图数据库选型评估者阅读。
一、Basic 权限的 UnImplemented 警告
现象
按官方文档配置 ConfigAuthenticator,启用 Basic 权限后,启动 / 调用时却提示:
授权模式 UnImplemented
参考社区 Issue:apache/incubator-hugegraph#1895
现状
截至目前,社区也未修复此问题。
亿级实体点环境同样基于 1.0.0.Release 部署,目前未启用 Auth 配置——权限安全让位于业务可用性。
备选方案
- 依赖网络层隔离(VPC、安全组)兜底权限
- 在应用层做访问控制(业务代码层校验)
- 等待社区修复,或自行二次开发
一句话:Basic 权限截至当前版本仍 UnImplemented,业务方接受网络层隔离兜底;安全性让位于可用性,是图数据库生产部署常见的妥协。
二、存储引擎选型 + Spark 版本冲突
2.1 为什么是 HBase,不是 RocksDB?
在内部开发测试时,HugeGraph 默认底层使用 RocksDB。但到了亿级实体点的客户环境,必须切到 HBase:
| 维度 | RocksDB | Cassandra | HBase |
|---|---|---|---|
| 数据量上限 | 十亿级 | 百亿级 | 千亿级 |
| 写入速度 | 一般 | 中等 | 较快 |
| 共用技术栈 | ❌ | ❌ | ✅ 与合作方共用 HDFS |
百亿/千亿级别的数据量下,RocksDB 已不够用;合作方在做数据分析时已全栈使用 HDFS,统一技术栈减少额外学习成本。
2.2 Spark 版本冲突:NoSuchMethod 异常
内部 Spark 3.x 调试好的 ETL 代码,到客户环境的 Spark 2.4.x 集群上直接报错 NoSuchMethod——典型的二进制不兼容。
解决方式
把集群从 Spark 2.4.x 升级到 3.1.1,并基于 3.1.1 重新打包:
- etl-loader 包(提供平台 taurus plugin 用的 lib)
- livy 下的 lib 包同步替换(仅一台机器替换,不影响 dmc)
踩坑点:替换 livy 的 lib 必须一台一台替换,不要批量升级——批量升级会让 dmc 的 spark-submit 链路出错。
一句话:百亿数据选 HBase,Spark 2.4 升 3.1.1 重打包;livy 库一台一台替换,别批量——血的教训。
三、批量写点失败:batch 与线程数调优
现象
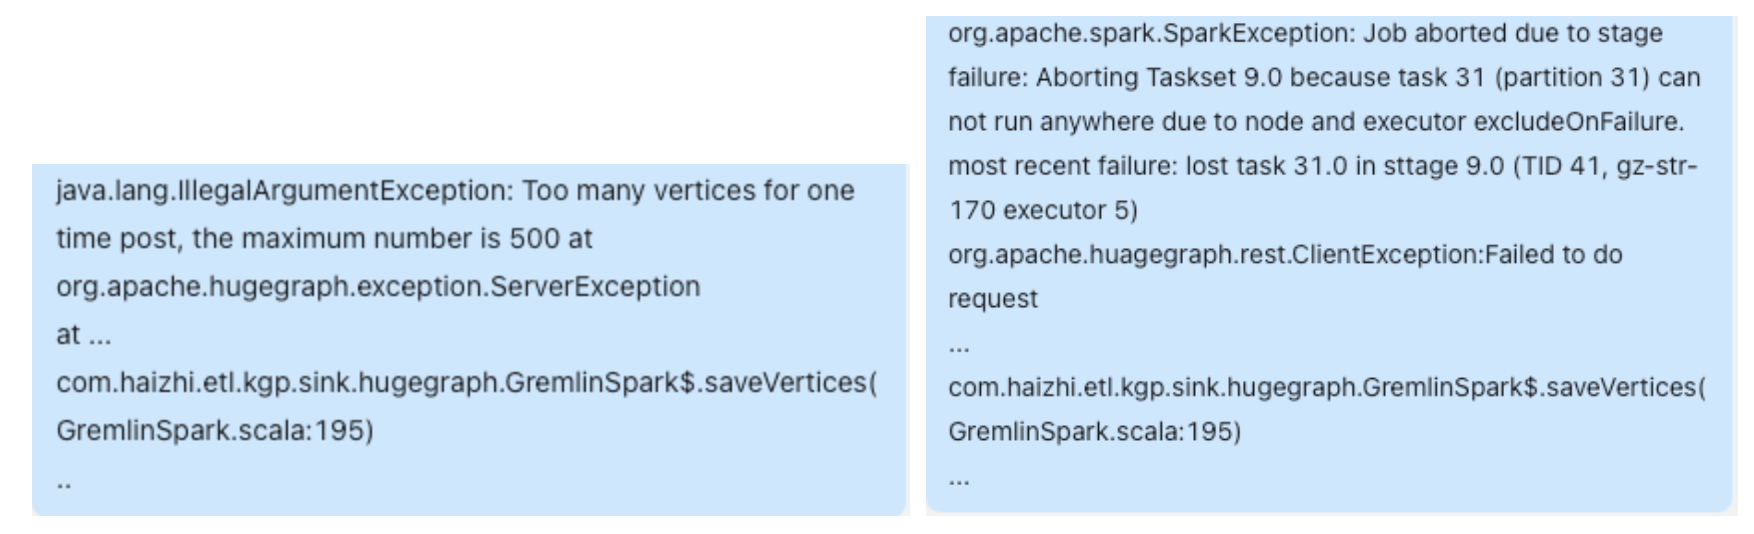
亿级手机号实体点写入时,两种报错交替出现:
- 报错 A:单批提交数据行 > 500 时报错
- 报错 B:按分区写数据时,最后一片分区报错(”对方数据库反应不过来”导致连接断开)
根因排查
| 报错 | 根因 |
|---|---|
| A | rest-server.properties 中 batch.max_vertices_per_batch 默认 500 |
| B | 写入线程数不足,对方数据库跟不上,连接断开 |
调优参数
| 配置 | 默认值 | 调整后 | 说明 |
|---|---|---|---|
batch.max_vertices_per_batch |
500 | 1500 | 单批点 / 边数 |
| 调平台接口批次 | 256 | 1000 | 平台侧接口批次 |
batch.max_write_threads |
2 * cpu * 0.5 |
60 | 写入线程数 |
踩坑点:线程数不是越大越好——设置超过 60 后,对方数据库(HBase)压力反而过大。
一句话:批次从 500 提到 1500,线程数提到 60——再大对方数据库就扛不住了,这条经验值压测一下基本都对得上。
四、Text 字段 65535 长度限制
现象
关系边上的 event_ids(Text 类型属性)写入失败:
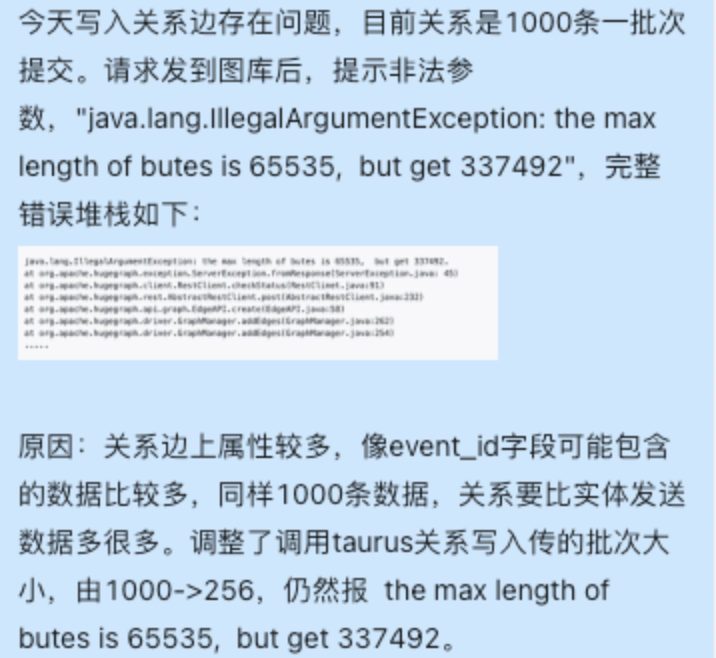
调整写入批次后,还是报同样的异常——这意味着不是批次数问题,是单条数据问题。
根因
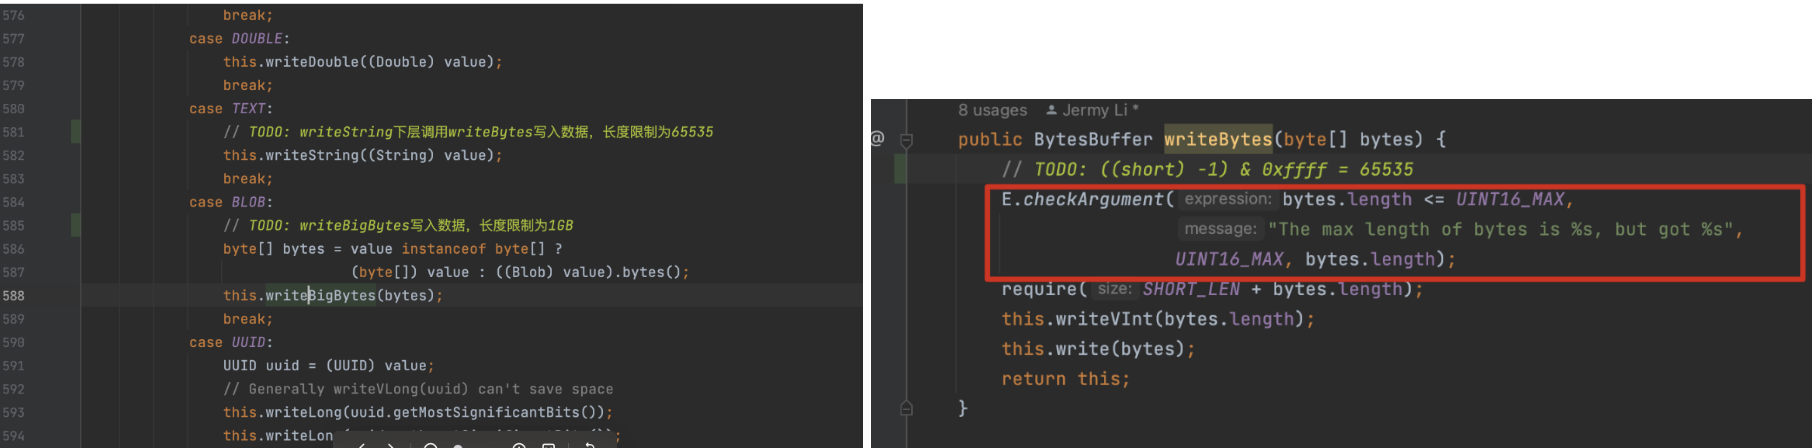
HugeGraph 图库按单行记录逐个属性写数据:
- Text 类型属性值的最大长度为 65535 字符
- 个别关系边上的
event_ids(Text 类型)超过 65535 - 单条不通过 → 整批失败(与批次大小无关)
踩坑点:把批次从 1000 调到 256 没用,因为不是批量问题,是单字段长度问题。
解决方案
写入前过滤:
length(event_ids) < 65535
4.1 客户端侧的同源问题:hugeclient 批量写 65535 字节限制
服务端写入限制之外,hugeclient(Java SDK)批量写也有一个独立的 65535 字节限制——但单位是字节而非字符:
java.lang.IllegalArgumentException: the max length of bytes is 65535, but get 337492
复现路径:用 hugeclient 的批量写入 API 推送一条边,event_ids 字段为 Text 类型,字节数达到 337492(约 33 万),直接报错。
与 Server 端 65535 字符限制的区别:
| 维度 | Server 端 Text 字段 | hugeclient 批量写 |
|---|---|---|
| 限制单位 | 字符数 | 字节数 |
| 阈值 | 65535 chars | 65535 bytes |
| 中文场景实际容量 | 约 2 万汉字(按 UTF-8 3 字节 / 字) | 约 2.1 万 ASCII 字符 |
| 触发位置 | TextProperty 写库 |
hugeclient 序列化层 |
踩坑点:同样的字段在两端有限制,但阈值和单位不同。一个汉字字符占 UTF-8 3 字节,所以中文场景下 hugeclient 的限制比 Server 端更严。
详细复现:hugegraph#2291
一句话:Text 字段 server 端限 65535 字符,hugeclient 限 65535 字节,单条失败整批挂——这两个限制踩过的同学都数小时起算。
五、gremlin 参数 255 限制
现象
图析 k 层展开时,gremlin 语句报错:
java.lang.IllegalArgumentException: The max number of supported arguments is 255, but found 500
    at org.codehaus.groovy.classgen.asm.CallSiteWriter.getCreateArraySignature(CallSiteWriter.java:74)
    at org.codehaus.groovy.classgen.asm.CallSiteWriter.makeCallSite(CallSiteWriter.java:336)
点击展开完整堆栈
``` at org.codehaus.groovy.classgen.asm.InvocationWriter.makeCachedCall(InvocationWriter.java:352) at org.codehaus.groovy.classgen.asm.InvocationWriter.makeCall(InvocationWriter.java:442) at org.codehaus.groovy.classgen.asm.InvocationWriter.makeCall(InvocationWriter.java:150) at org.codehaus.groovy.classgen.asm.InvocationWriter.makeInvokeMethodCall(InvocationWriter.java:124) at org.codehaus.groovy.classgen.asm.InvocationWriter.writeInvokeMethod(InvocationWriter.java:509) ```根因
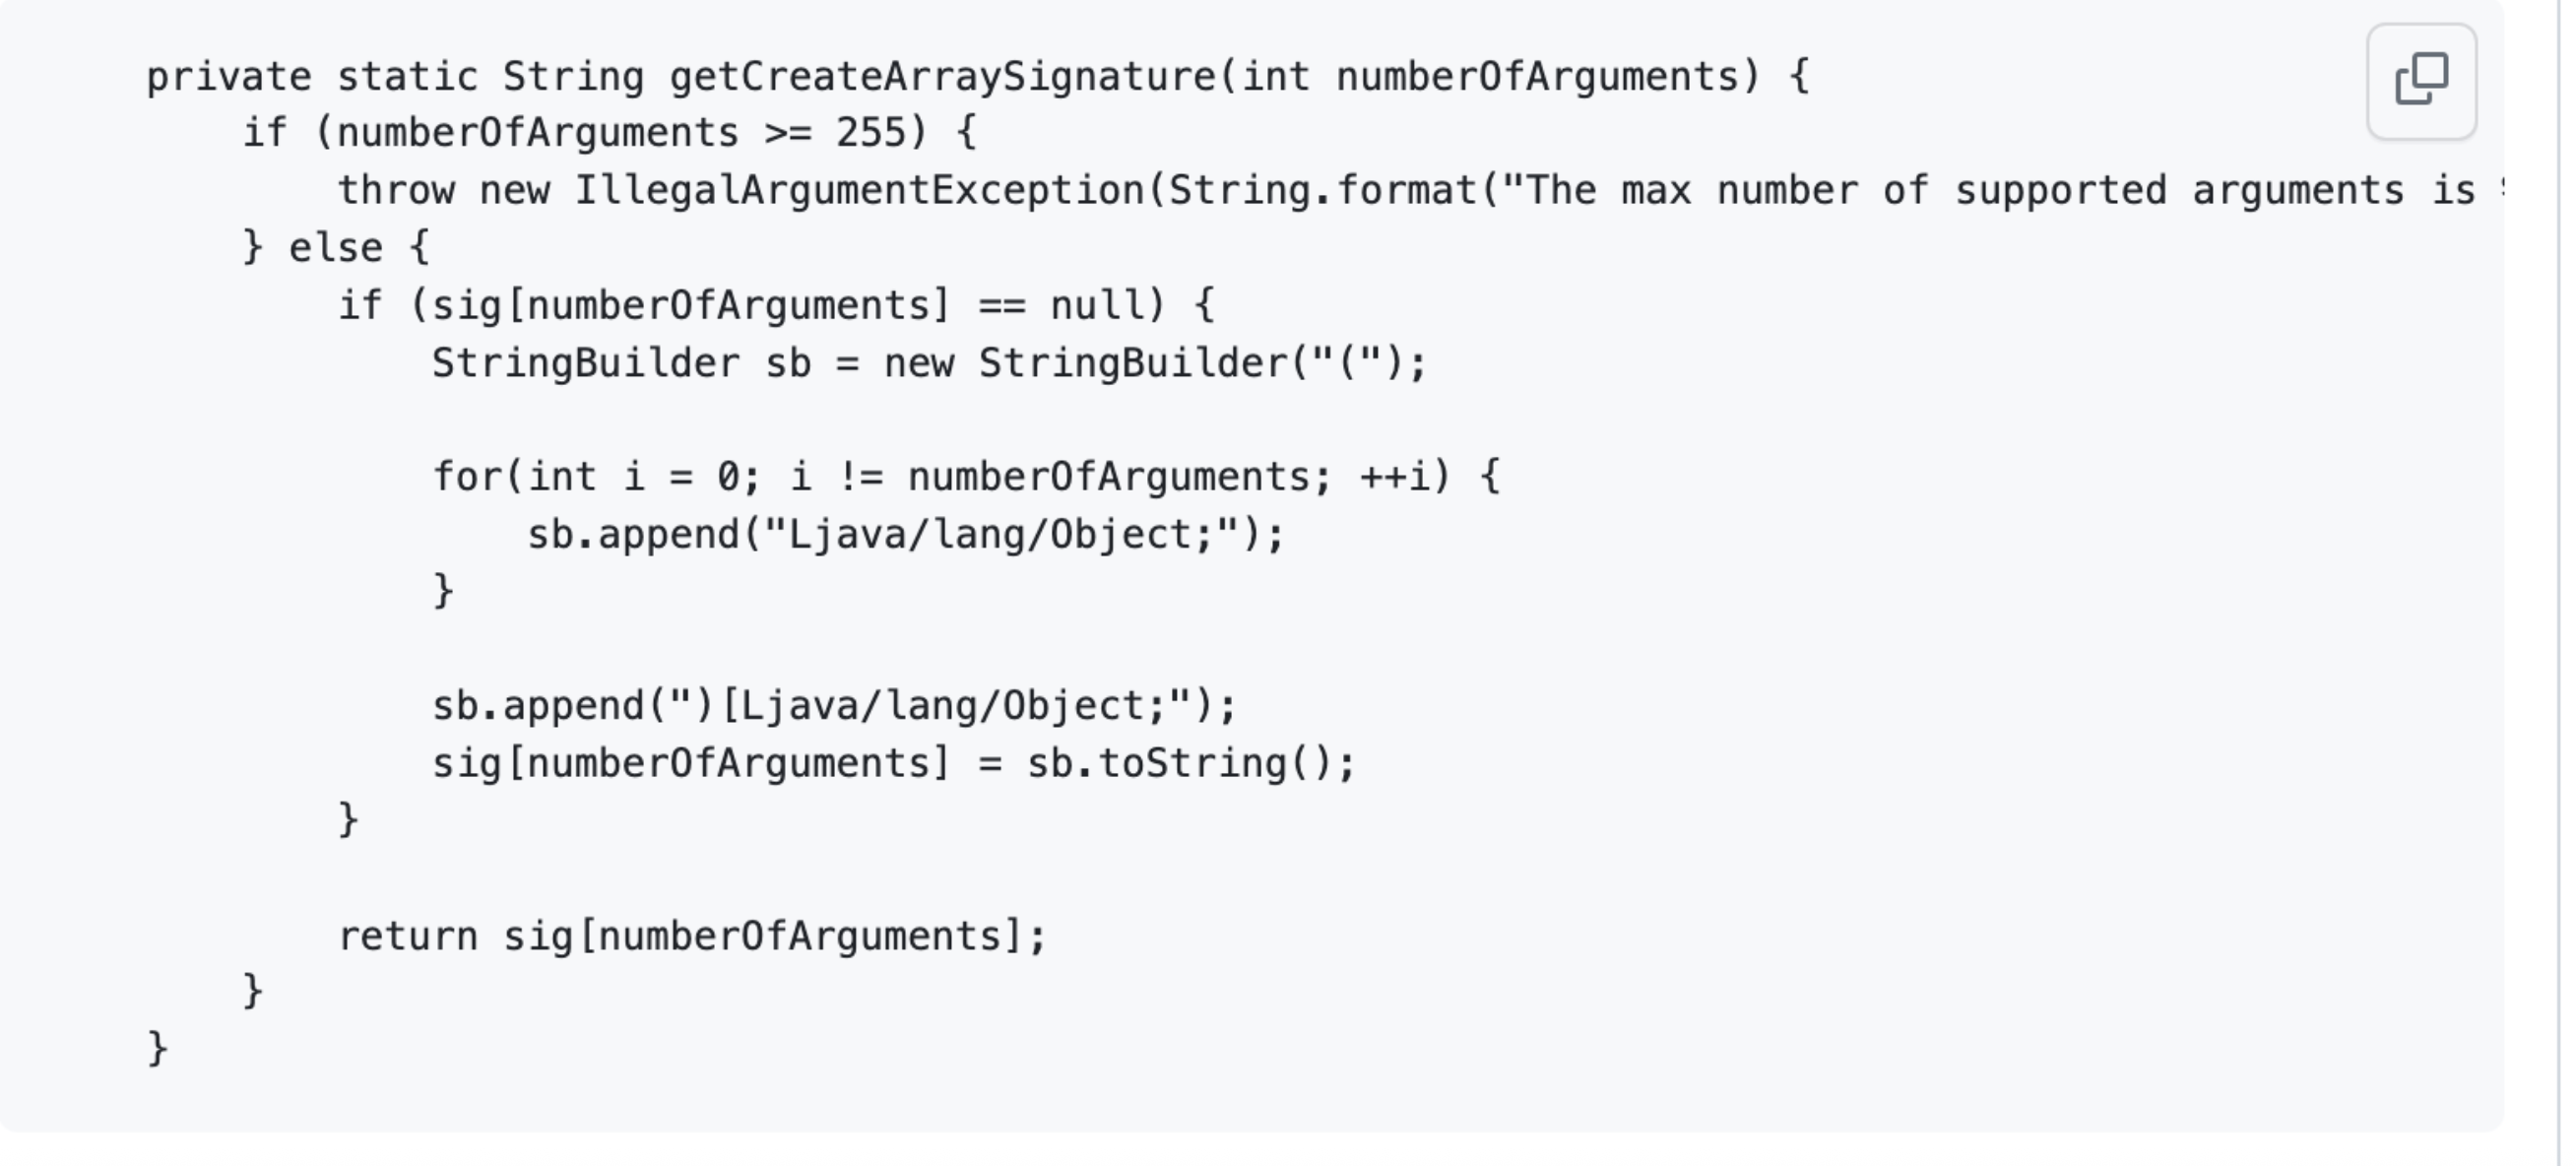
Groovy 底层 ASM 的硬限制——CallSiteWriter.getCreateArraySignature 在编译时生成数组创建指令,而数组大小由 JVM 限制为 255。
目前的业务 workaround 是关闭”图内关联”选项。
一句话:gremlin 参数超 255 是 Groovy 底层硬限制,临时关”图内关联”——长远要重构查询,把超长 in 列表改成 OLTP REST API。
六、点扩展 too many rows:or() → within() 改写
现象
点扩展 gremlin 执行报:
too many rows >= 800000
亿级实体点规模下,gremlin 写法直接影响执行性能。
原写法(慢)
g.V().or(
    g.V().has('phone', 'object_key', '1029283xx'),
    g.V().has('phone', 'object_key', '1029283xx'),
    ...
)
每次 has() 都触发一次全扫描,多个 or 串联就是 N 次全扫描。
优化写法(快)
g.V().has('phone', 'object_key').within('1029283xx', '1029283xx', ...)
within 走索引精确查询,一次扫描得到结果集。
原理对比
| 写法 | 扫描方式 | 亿级点性能 |
|---|---|---|
or() + 多次 has() |
全表多次扫描 | ❌ 慢,触发 too many rows |
within() 单次 |
索引精确查询 | ✅ 快 |
一句话:
or()+ 多次has()是 N 次全扫,亿级点必改within()——这两个写法执行路径完全不同,性能差一个数量级。
七、hugegraph-loader 工具链:ETL 提速 + 关系边冲突修复
7.1 为什么用 loader,不用 taurus?
| 链路 | 流程 | 实测速度 |
|---|---|---|
| 现状 taurus | DMC (Hive) → taurus → Spark → HugeGraph + ES | 9.5 万/s(10 节点) |
| loader | Hive → csv / parquet → loader 直写 | 10 万条/s(项目侧实测) |
客户期望吞吐量:70~80 亿/天。
当前 9.5 万/s × 86400 秒 = 约 82 亿/天——基本达标,但写入速度仍有提升空间,loader 是更优解。
提速原理(2 个关键)
- 数据预处理:loader 读取 csv/parquet 是预先处理好的数据,而 taurus 链路包含完整的数据清洗、转换流程;读文件比读 DB 快几个数量级
- 并发模型:loader 在数据写入实现上使用线程池;线程并发比进程并发(依赖 cpu 数量)开销更轻,能支持更高并发数
7.2 loader 命令模板
[hugegraph@loader-host-001 hugegraph-loader-1.0.0]$
  sh bin/hugegraph-loader.sh \
    --incremental-mode true \
    -g test_graph_01 \
    -f /data/loader/mapping.json \
    -s /data/loader/schema.groovy \
    -h 192.0.2.20 \
    -p 28081 &
关键参数
| 参数 | 含义 |
|---|---|
--incremental-mode true/false |
是否增量写入 |
-g <graph> |
写入的图实例名 |
-f <file> |
mapping.json(HDFS 文件位置) |
-s <file> |
schema.groovy(实体 schema 约束) |
-h <host> / -p <port> |
Graph 服务地址 |
关于 mapping.json / schema.groovy:官方文档有完整说明。简单说,这两个文件先创建约束,再走 loader 加载数据的逻辑——约束信息在启动阶段创建好,再批量推数据。
7.3 关系边 object_key 冲突问题
现象:
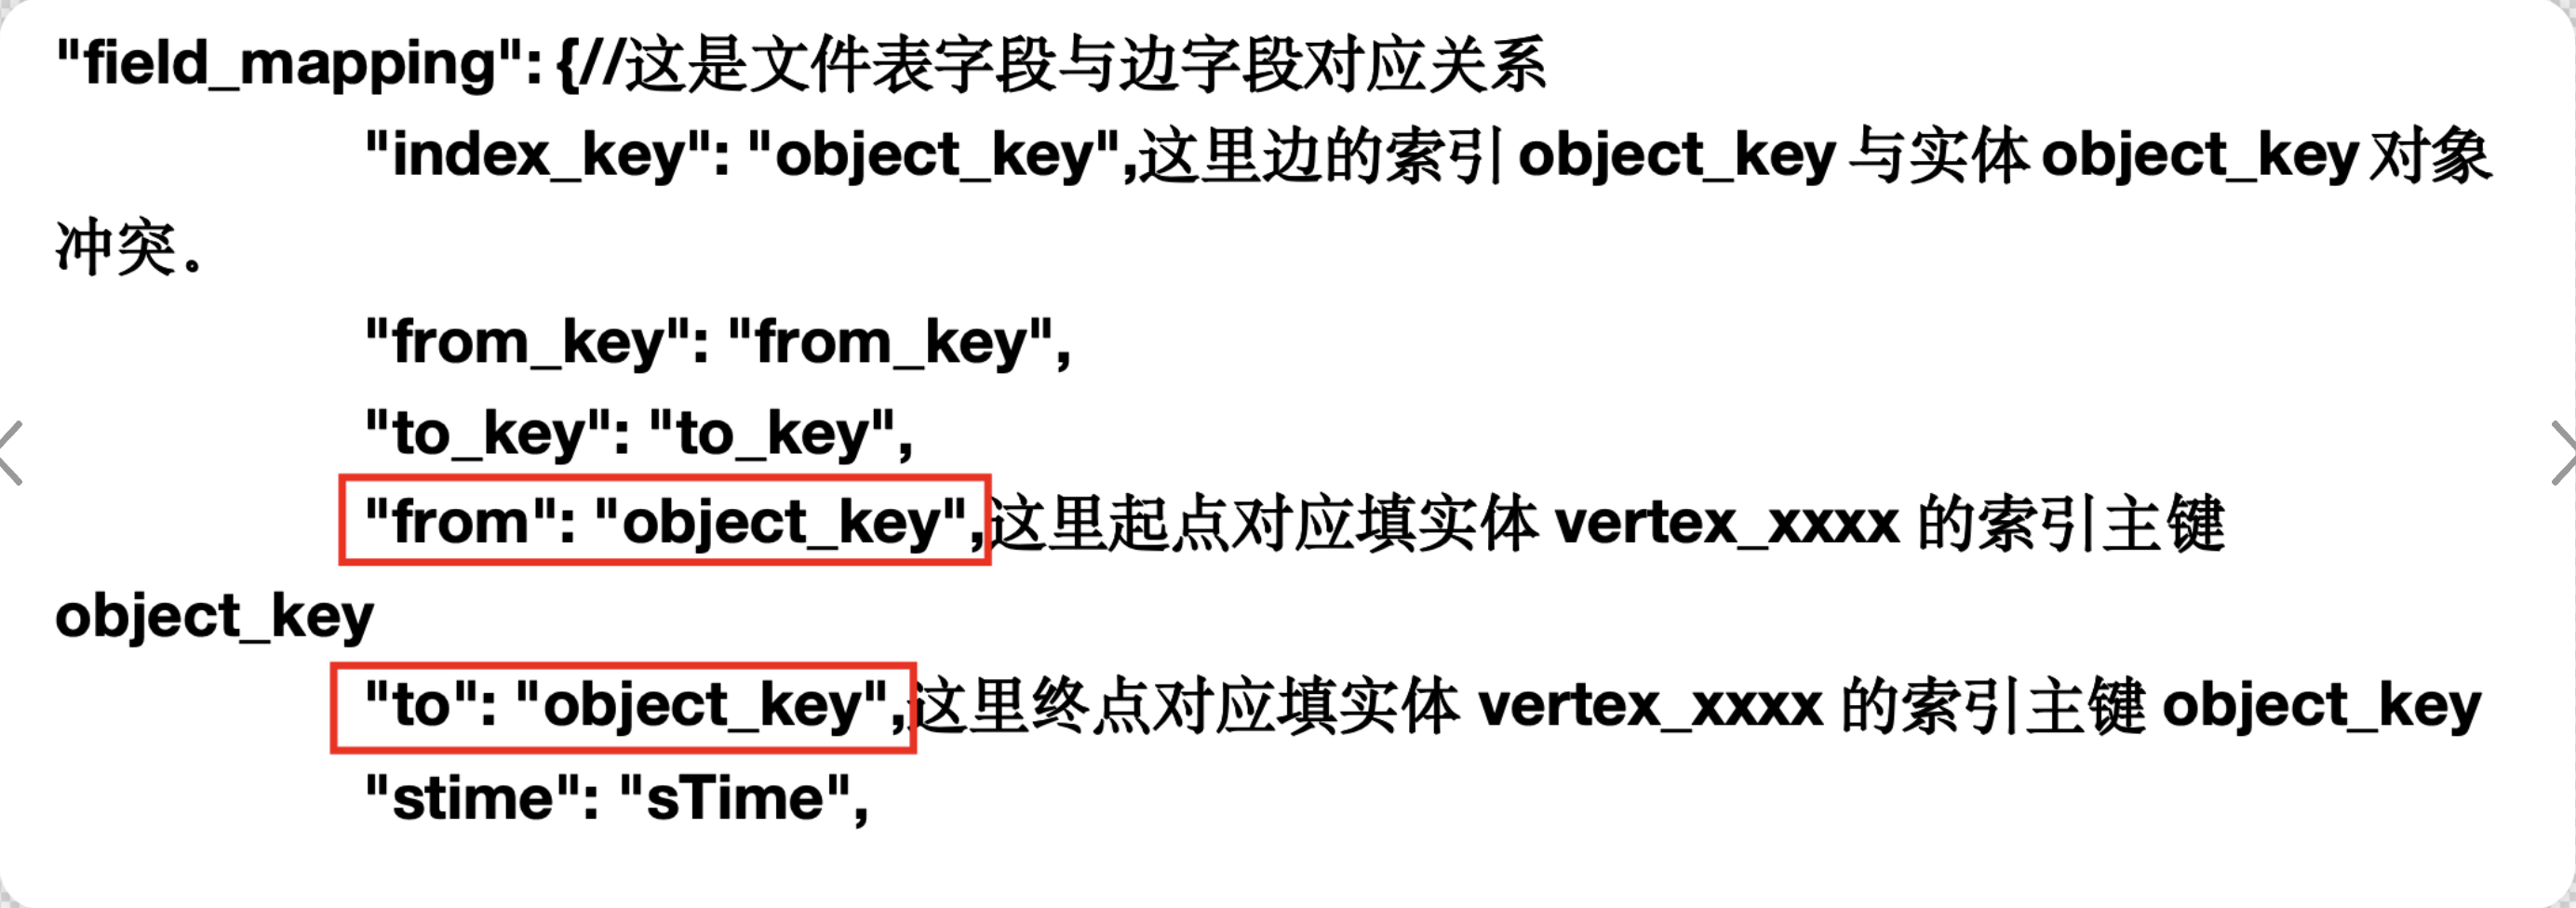
在 field_mapping 中,关系的 "from" 和 "to" 都引用了实体的 "object_key":
{
  "field_mapping": {
    "from": "object_key",
    "to": "object_key"
  }
}
后果:
- 实体的
"object_key"与关系边的"object_key"冲突 - Loader 只取其中一个实体的
object_key作为关系边的object_key - 双向边(A→B、B→A)数据丢失——因为 object_key 相同被认为重复
修复:
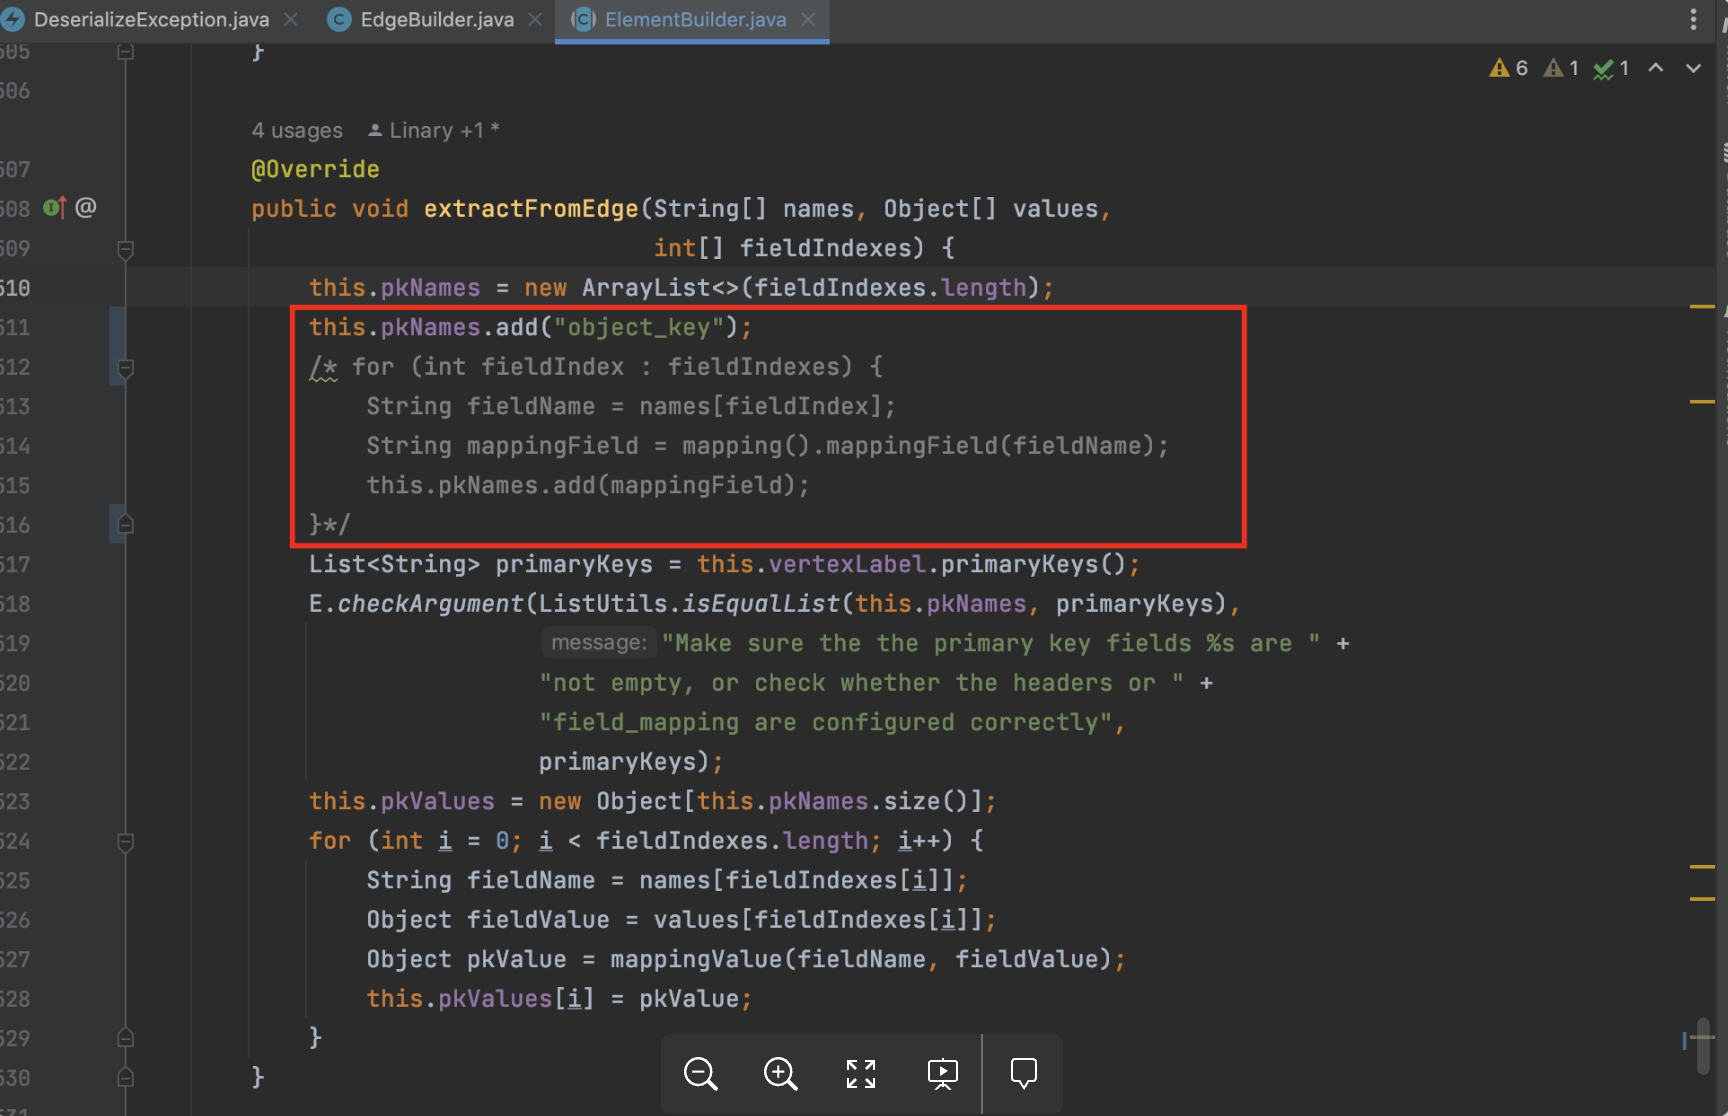
调整 HugeGraph Loader 模块的字段映射配置,关系边的主键字段值改为 "object_key",重新编译生成 jar 包,再通过 loader 导入数据。
踩坑点:loader 的
field_mapping与schema.groovy的字段定义是两个独立入口,两边都要改才能避免冲突。
一句话:loader 比 taurus 快,因为读 csv 比读 DB 快 + 线程池比进程开销轻——亿级数据这两条差距显性放大。
八、hugegraph-client 连接:jakarta.ws.rs 找不到
现象
在 Java 项目里通过 hugegraph-client 连接图库时,启动 / 调用时报:
class not found jakarta.ws.rs.ProcessingException
根因
hugegraph-client 依赖 Jakarta RESTful Web Services(JAX-RS)规范:jakarta.ws.rs.*。
Spring Boot 3.x / Jakarta EE 9+ 已经把 javax.ws.rs 迁移到了 jakarta.ws.rs;如果项目里既引入了 Spring 3.x,又引入了 hugegraph-client,会出现:
hugegraph-client编译期依赖javax.ws.rs.*- 运行时 classpath 里只有
jakarta.ws.rs.*(Spring 3 引入) - 启动时找不到
javax.ws.rs.ProcessingException
解决方案
方案 A(推荐):业务工程排除 javax.ws.rs.*,统一用 jakarta.ws.rs.*:
<dependency>
    <groupId>org.apache.hugegraph</groupId>
    <artifactId>hugegraph-client</artifactId>
    <version>1.0.0</version>
    <exclusions>
        <exclusion>
            <groupId>javax.ws.rs</groupId>
            <artifactId>javax.ws.rs-api</artifactId>
        </exclusion>
    </exclusions>
</dependency>
<dependency>
    <groupId>jakarta.ws.rs</groupId>
    <artifactId>jakarta.ws.rs-api</artifactId>
    <version>3.1.0</version>
</dependency>
方案 B:降 Spring Boot 到 2.x(保留 javax 命名空间)——但要承担升级延后的代价。
详细 issue:hugegraph#2259
一句话:Spring 3 + hugeclient 会撞
jakarta.ws.rs,业务工程里排除javax.ws.rs-api、统一依赖 jakarta——这是 Spring 3 升级到图数据库场景的标配。
九、gremlin 高级查询:not contains 与 OLTP 触发
gremlin 语法和 HugeGraph 实现细节之间存在不少”语法看着对、运行时报错”的坑。下面两个是社区里高频出现的两个。
9.1 not contains 怎么写?
期望语法:
g.V().has('name', 'NOT_CONTAINS', '张三') // 想表达"名字不包含张三"
报错:HugeGraph 的 TextP.REGEX / TextP 实现里没有原生支持 NOT_CONTAINS,直接报语法错。
替代写法
利用 not() + containing()(contain 是 contains 的别名):
g.V().has('name', containing('张三')).count()   // 包含
g.V().not(has('name', containing('张三')))      // 不包含
或者用正则 + not():
g.V().not(has('name', TextP.regex('.*张三.*')))
注意:上述写法对已分词的 Text 字段未必生效——TextP 匹配的是底层倒排索引 token,词与词之间 not 组合不一定等价于字符串不包含子串。生产场景务必在自己的数据上验证。
详细 issue:hugegraph#2350
9.2 用 gremlin 触发 OLTP 查询
期望:希望通过一条 gremlin 触发底层 OLTP 查询接口(低延迟、命中索引),但 gremlin 默认走的是 OLAP 路径。
OLTP 与 OLAP 的区别
| 模式 | 路径 | 延迟 | 适用 |
|---|---|---|---|
| OLAP | 全图遍历 + 算子执行 | 高 | 复杂图算法 |
| OLTP | 走索引 + KV 查询 | 低 | 单点 / 邻居查询 |
HugeGraph 当前版本通过 gremlin 提交查询时,统一走 OLAP 路径,没有自动切换 OLTP 的开关。
workaround
- 应用代码直连:在业务层绕过 gremlin,直接调用 HugeGraph REST API 的 OLTP 接口(如
/graphs/{graph}/traversers/vertices、/traversers/edges) - 简化 gremlin:用
has().out().count()这种短链式 gremlin 走索引,避免多跳遍历
详细 issue:hugegraph#2544
总结:gremlin 表达力强但缺乏 native;写复杂查询前,先评估能不能用 OLTP REST API 直接命中,避免”明明一个 KV 查询,却走了全图计算”的尴尬。
一句话:not contains 用
not(has(...)),或干脆直连 OLTP REST API——gremlin 默认 OLAP 路径,简单查询也能拖到秒级。
小结
10 个问题速查表
| # | 问题 | 关键参数/配置 | 状态 |
|---|---|---|---|
| 1 | Basic 权限 UnImplemented | Issue #1895 | 社区未修复,业务方接受未启用 |
| 2 | Spark 2.4.x → 3.1.1 升级 | etl-loader / livy 重打包 | 已解决 |
| 3 | 批量写点失败 | batch.max_vertices_per_batch: 500→1500;batch.max_write_threads → 60 |
已解决 |
| 4 | Text 字段 65535 限制(server 端) | 写入前过滤 length < 65535 |
已解决 |
| 4.1 | hugeclient 批量写 65535 字节(client 端) | Issue #2291 | 字节 vs 字符双阈值 |
| 5 | gremlin 参数 255 限制 | Groovy 底层硬限制 | 临时关闭”图内关联” |
| 6 | 点扩展 too many rows | or() 改写为 within() |
已解决 |
| 7 | loader 关系边 object_key 冲突 | 改 field_mapping,重新打包 jar | 已解决 |
| 8 | hugegraph-client 连接(jakarta.ws.rs) | Issue #2259 | 排除 javax.ws.rs,统一用 jakarta |
| 9 | gremlin not contains / OLTP 触发 | Issue #2350 / #2544 | 用 not(has(...)) 或直连 OLTP API |
一句话方法论
权限让步、版本对齐、配置调优、查询改写、工具切换。
部署图数据库不像部署普通数据库,适配工作量往往大于开发工作量。每个”小问题”背后都是一行配置、一段源码改动、一个业务妥协。下次再遇到亿级图数据接入,希望这份清单能少让你踩两个坑。
下一篇将聚焦图数据库的性能调优主题:HugeGraph + Elasticsearch 后端索引的 shard 设计、批量写入压测、JVM GC 调优,敬请期待。